

以太坊联合创始人 Vitalik Buterin 表示,本地人工智能(AI)已接近能够胜任大量日常任务。他在自己的笔记本电脑上运行了阿里巴巴的 Qwen3.8-Flash-Next,并晒出了推理速度结果。
与 ChatGPT 不同,该设置全程无需连接云端服务器。模型本地部署于设备上,所有查询均由设备自主处理。
Vitalik Buterin 本地 AI 实测结果:推理速度可满足日常使用
他的笔记本电脑采用了 AMD Strix Halo 芯片。与传统计算机通常将任务分别交由处理器和独立显卡分担、二者各自配备独立内存池不同,Strix Halo 将二者集成在一片芯片上,并共享统一内存池。
这一设计尤为关键,因为 AI 模型运行前必须完全加载进内存。普通显卡往往只有 8 至 24 GB 显存,远不足以承载如此规模的大模型。而 Strix Halo 设备最高可搭载 128 GB 内存,且处理器和显卡均可灵活调度。这意味着,以往只有服务器才能运行的大模型,如今一台笔记本就能容纳。
他公布的推理速度,已足以应对常规办公需求。简短提示词的响应速度流畅,输出几乎实时;但当输入扩展到上万词时,模型生成速度开始放缓——超长文档处理仍是当前短板。
阿里巴巴于 8 月 26 日开放 Qwen3.8-Flash-Next 权重。团队介绍称,该模型参数规模达 1,250 亿,但实际每次只激活其中的 60 亿,极大降低了对内存资源的需求。
Buterin 将其命名为 Qwen3.8-Flash,而阿里巴巴正式发布的下载版本为 Qwen3.8-Flash-Next。其“巨无霸”版本 Qwen3.8-Max 在 8 月曾创下同类基准测试高分。
Vitalik Buterin. Source: XQwen 3.8 flash is truly impressive, and llama.cpp has been rapidly getting better and better at processing it
— vitalik.eth (@VitalikButerin) September 17, 2026
columns are: pre-existing prompt, new prompt, generated, input tok/s, output tok/s
This is on my laptop (strix halo). I think we're very close to the point where you… pic.twitter.com/v5Ze4Fv5Wr
本地部署 AI:隐私保护逻辑的根本转变
Buterin 指出,本地 AI 的收益不仅限于性能提升。由于模型在本地设备直接响应,无需将任何请求上传至第三方平台,用户隐私安全大幅增强。
面对对算力等资源要求更高的场景,他建议采用“本地+云端”混合处理:本地模型优先生成初步结果,将敏感信息从输入中剥离后,剩余部分再交由大型云端模型处理。
“让本地模型做中转,把个人隐私数据过滤掉,再请求云端强力模型,防止隐私信息泄漏。”
实际操作中,用户可以让本地模型智能筛选,如自动剔除姓名、钱包地址、源代码等敏感内容,仅将问题核心传递给云端 AI。这样能大幅降低敏感数据外泄概率,但并不能百分百完全杜绝风险。
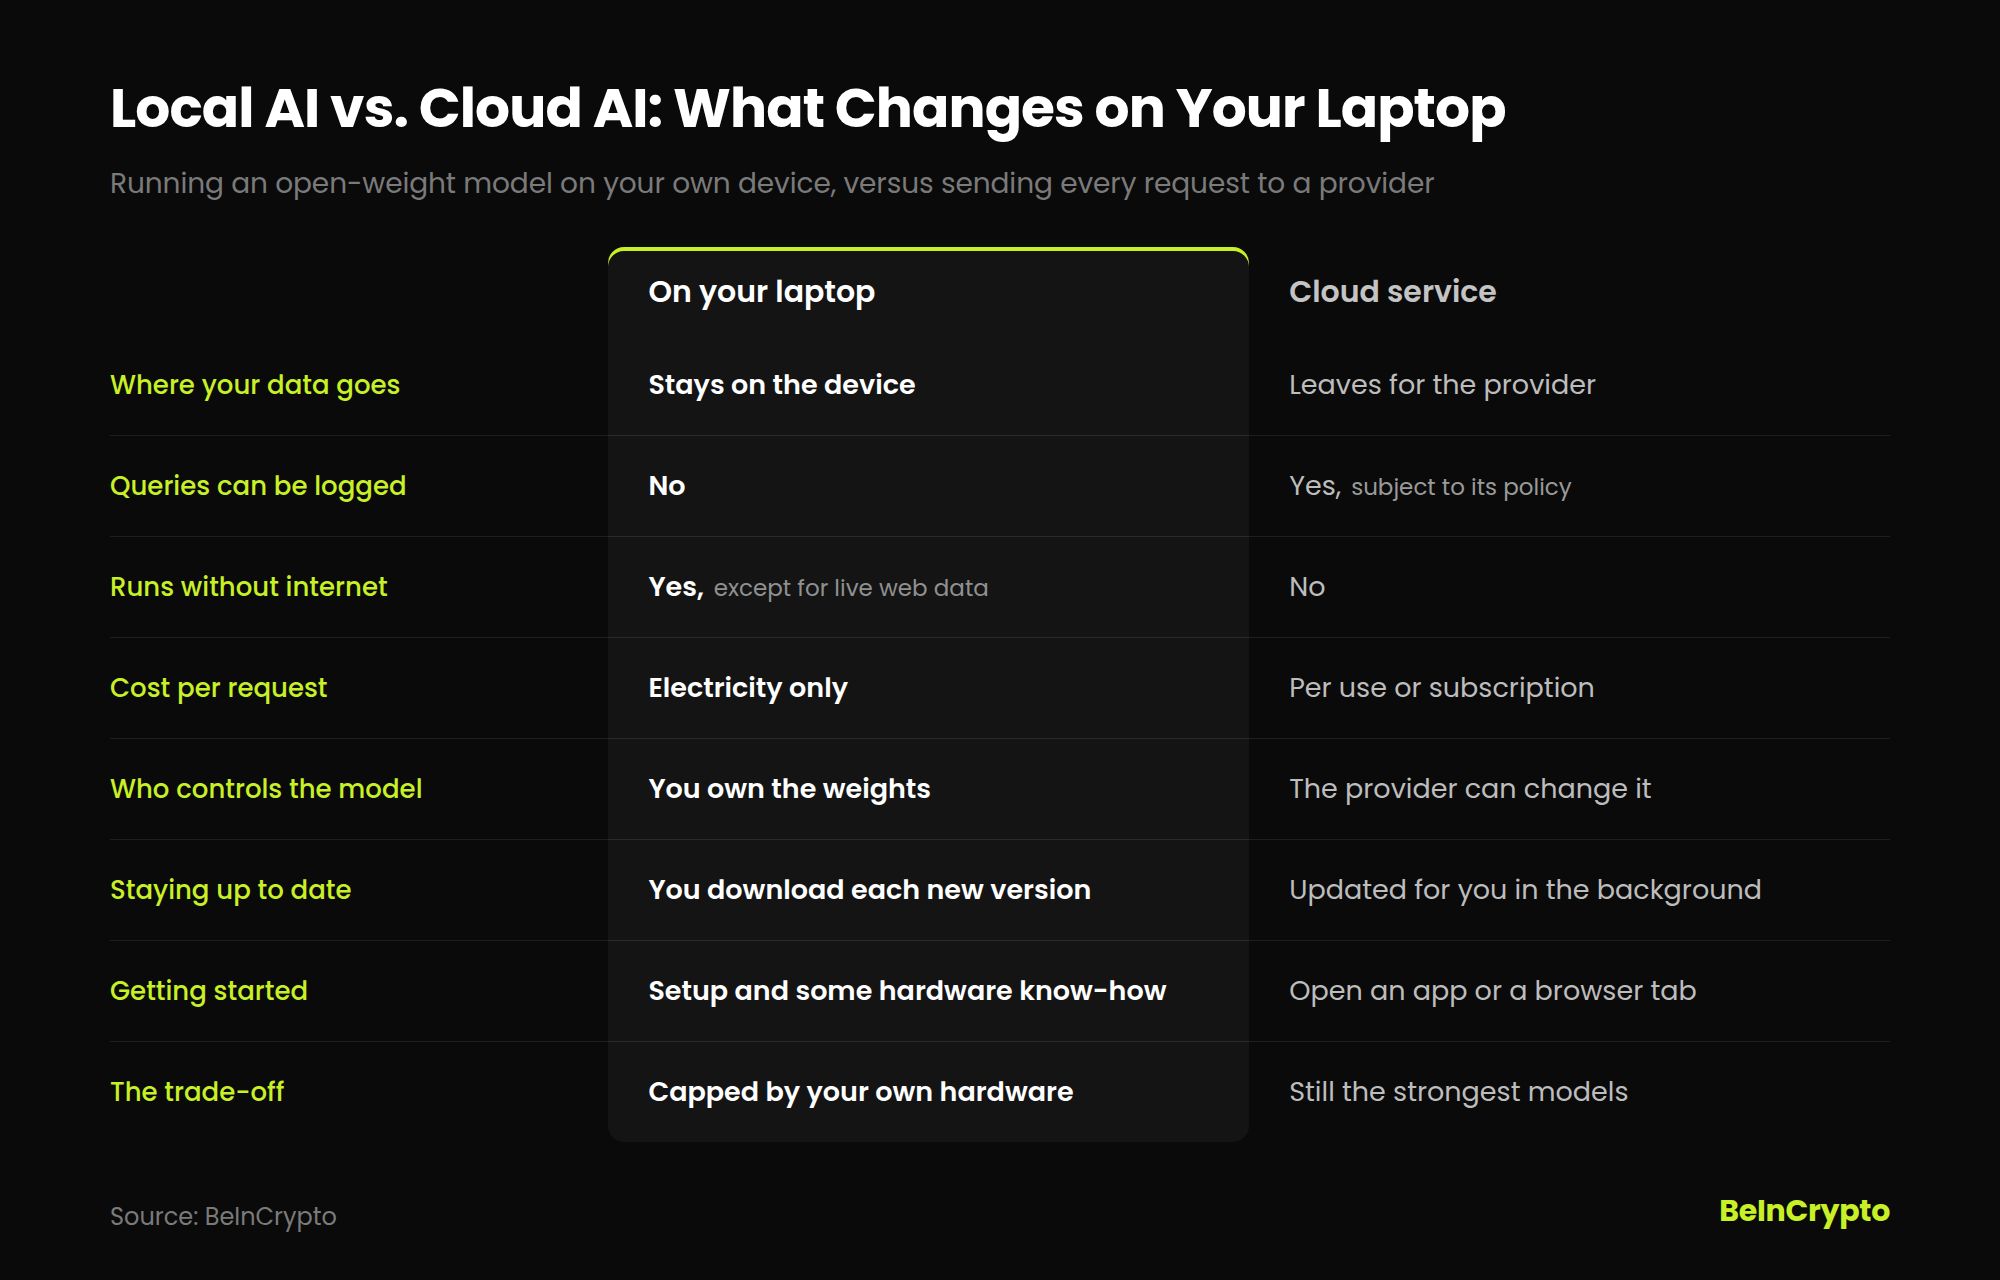 对比图:笔记本本地 AI 与云端服务。来源:BeInCrypto
这样的呼吁与他以往的立场一脉相承。在欧盟聊天控制法案争议期间,他曾公开警告数据监控风险。同时,许多加密货币用户也基于类似的原因,持续推动更加严格地限制 AI 智能体权限。
今年 5 月,有一宗集体诉讼指控 OpenAI 疑似将 ChatGPT 用户的提问内容共享给 Meta 与谷歌,相关诉讼已在推进中。(详情)
目前,云服务提供商仍然掌控主导地位。但随着本地算力不断提升,越来越多日常任务正逐步从云端服务器迁移至本地。同时,低价共享内存硬件正持续普及,进一步推动这一趋势。
市场的核心悬念是:个人愿意为数据自主权牺牲多少能力?
在 cn.beincrypto.com 阅读由 Phil Haunhorst 撰写的原始文章 V神推动本地AI笔记本能替代ChatGPT吗