

SpaceXAIがGrok 4.7をリリースし、独立した評価で主要AIラボ上位4位に入った。
独立評価機関のArtificial Analysisによると、同モデルはインテリジェンス・インデックスで46点を記録し、Grok 4.6を2点上回った。上位にはClaude Fable 5.1、GPT-6 Astra、Claude Opus 5が並ぶ。
Grok 4.7がSpaceXAIをAIラボ上位4位に押し上げ
イーロン・マスク氏はリリース前に、同モデルが2兆1000億パラメータ規模で現行の全モデルを超えると述べた。さらにSpaceX社内データもトレーニングに活用したとした。
最新ニュースはXアカウントで随時配信
Grok 4.7 is here.
— SpaceXAI (@SpaceXAI) September 21, 2026
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
では、Grok 4.7の実際の性能はどうか。プロフェッショナルな業務課題を想定したArtificial Analysisのベンチマーク「AA-Briefcase」では、Grok 4.7がEloレーティング1657を記録。Grok 4.6から111ポイント上昇し、Claude Opus 5に近づいた。
GDPval-AAではEloレーティング1695となり、前世代比で90ポイント差。コーディング関連でも同様の傾向。
自社のコーディングエージェント「Grok Build」と組み合わせた場合、Grok 4.7はコーディングエージェント・インデックスで56点となり、Grok 4.6を9点上回った。
GPT-5.6 Solを上回り、AnthropicのClaude Fable 5.1、GPT-6 Astra、Opus 5のみに迫る。
「Grok 4.7はインテリジェンス・インデックスで46点を記録、SpaceXAIを主要AIラボ上位4社に押し上げた。コーディングエージェント・インデックスも改善し、GPT-5.6 Solを上回った」と投稿に記載。
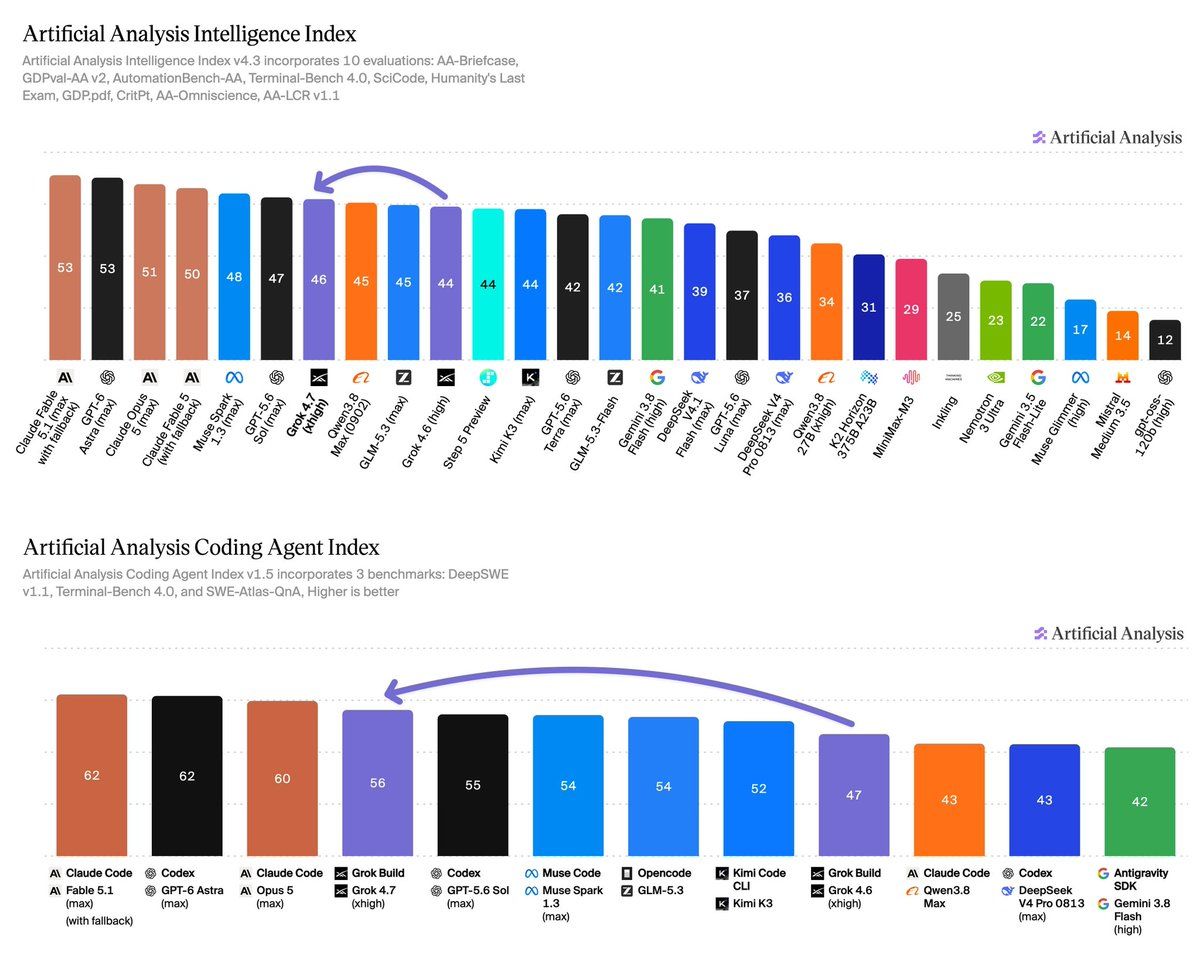 Grok 4.7のパフォーマンス 出典: X/Artificial Analysis
一方で、その他の分野では大きな変化はなかった。Terminal-Bench 4.0で4.5ポイント、GDP.pdfで3ポイント向上したにとどまる。AA-LCRやAutomationBench-AAテストではスコアが低下した。Grok 4.5は7月のAutomationBenchでトップを獲得しており、マスク氏による「Claude Opus並み」を裏付けていた。
成長の代償はトークン利用料
料金体系に変更はない。Grok 4.7の利用料は入力トークン100万件ごとに2ドル、出力トークン100万件ごとに6ドル。キャッシュヒットは0.5ドルの割引価格、Grok 4.6と同じ50万トークンのコンテキストウィンドウも継続。
ただし、回答あたりの処理量が大幅に増加している。Artificial Analysisの推計では、インデックスタスクごとに平均8万1000出力トークンを要し、Grok 4.6の3万6000やGPT-6 Astraの2万7000を大きく上回る。結果、単価据え置きでも課題ごとのコストは上昇傾向。
こうした大量トークン消費は、12億6000万ドルの損失を報告した部門に重くのしかかる。一方、マスク氏は9月14日、Grok 4.8のトレーニング完了が1週間以内になると述べた。
また同氏は、今後リリース予定のGrok 5が汎用人工知能(AGI)に到達するモデルになるとの見方を示した。次回リリースでは、追加の計算資源を消費せず順位を上げられるかが問われる。
YouTubeチャンネル登録はこちら。識者や記者による専門インサイトを配信中
https://youtu.be/IcgIaeIE7LI
jp.beincrypto.com でKamina Bashirによるオリジナル記事 イーロン氏が「Grok 4.7は全モデル超える」と発言 実現したか を読む