

SpaceXAI, Grok 4.7’yi piyasaya sürdü; bağımsız puanlar onu öncü yapay zekâ laboratuvarları arasında dördüncü sıraya yerleştiriyor.
Bağımsız karşılaştırma şirketi Artificial Analysis, bu modeli Intelligence Index’te 46 puanla değerlendirdi. Grok 4.7 bu skorla Grok 4.6’yı 2 puan geçti. Claude Fable 5.1, GPT-6 Astra ve Claude Opus 5 ise hala üst sıralarda yer alıyor.
Grok 4.7: SpaceXAI’yi İlk Dörtteki Yapay Zekâ Laboratuvarları Arasına Taşıyor
Elon Musk modelin lansmanından önce bu yazılımın 2,1 trilyon parametreli bir temelde çalışacağını ve mevcut tüm modelleri geride bırakacağını söylemişti. Ayrıca model eğitiminde SpaceX şirket verilerinin de kullanıldığını ekledi.
Bizi X’te takip edin ve en güncel haberleri anında alın
Grok 4.7 is here.
— SpaceXAI (@SpaceXAI) September 21, 2026
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
Peki Grok 4.7’nin gerçek performansı nasıl? Gerçekçi profesyonel iş görevleri için Artificial Analysis’ın oluşturduğu AA-Briefcase testinde Grok 4.7 tam 1.657 Elo puanı aldı. Bu, Grok 4.6’nın tam 111 puan önünde ve modelin seviyesini Claude Opus 5’in yakınına taşıyor.
GDPval-AA testinde model, 1.695 Elo puanına ulaşarak selefinden 90 puan öne geçti. Kodlama sonuçlarında da benzer bir artış dikkat çekiyor.
Kendi kodlama ajanı Grok Build ile eşleştirildiğinde, Grok 4.7 Kodlama Ajanı Endeksi’nde 56 puan aldı. Bu skor, Grok 4.6’nın dokuz puan üzerinde.
Model, GPT-5.6 Sol’u geride bıraktı ve şimdi sadece Anthropic’in Claude Fable 5.1’i, GPT-6 Astra ve Opus 5’in arkasında yer alıyor.
‘Grok 4.7, Artificial Analysis Intelligence Index’te elde ettiği 46 puan ile SpaceXAI’yi ilk 4 yapay zekâ laboratuvarı arasına taşıyor. Kodlama Ajanı Endeksi’nde de artış gerçekleşti ve GPT-5.6 Sol geride bırakıldı’ ifadelerine yer verildi.
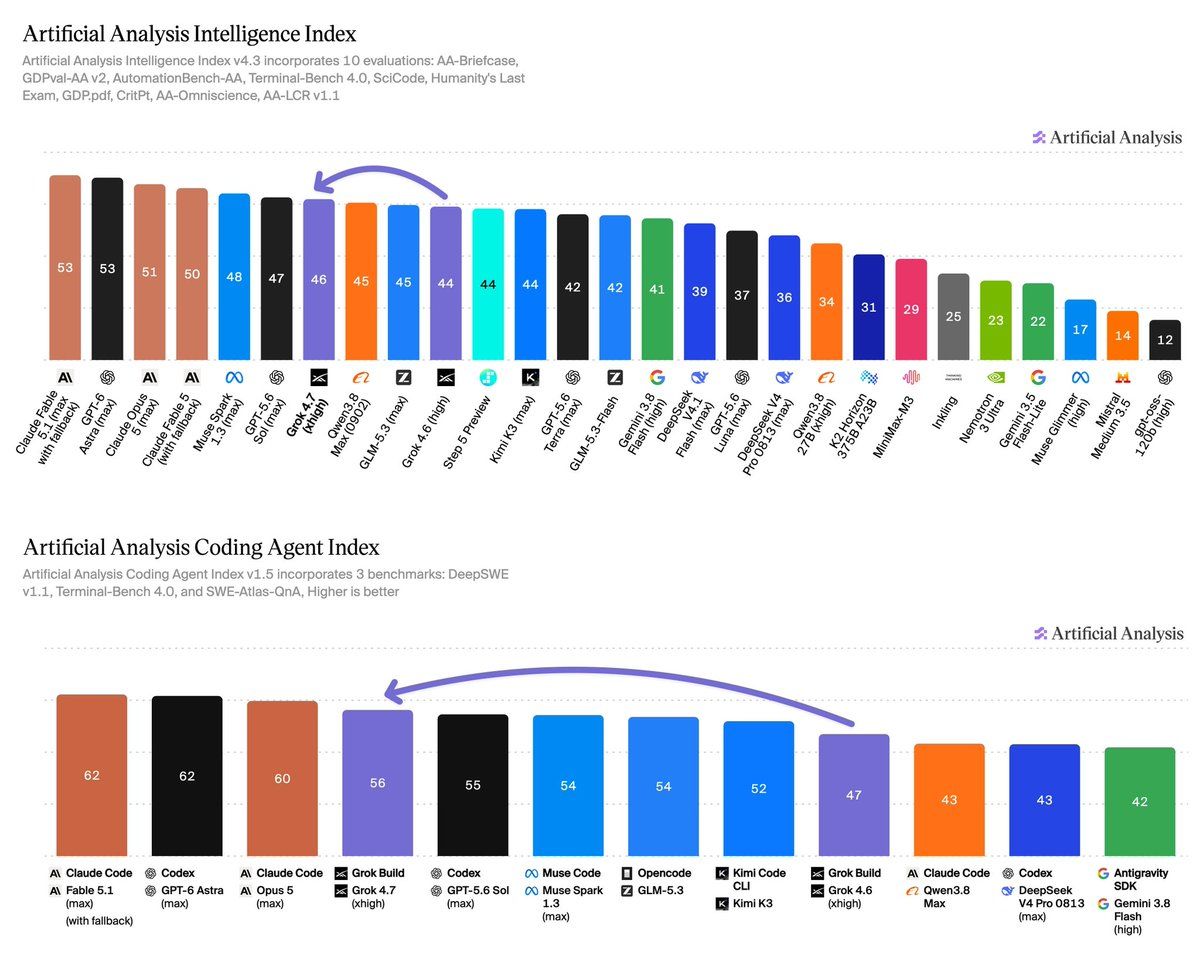 Grok 4.7'nin performansı nasıl? Kaynak: X/Artificial Analysis
Diğer tarafta ise modelde kayda değer bir değişim görülmedi. Terminal-Bench 4.0’da %4,5, GDP.pdf testinde ise 3 puan artış yaşandı. Ancak AA-LCR ve AutomationBench-AA testlerinde skorlar düştü. Grok 4.5, temmuz ayında AutomationBench’te zirvedeydi ve bu durum Musk’ın Claude Opus’a yetiştiği iddiasını desteklemişti.
Başarıların Bedeli: Artan Token Maliyeti
Fiyatlandırma tablosunda değişiklik olmadı. Grok 4.7 hâlâ her bir milyon giriş token'ı için 2 dolar, her bir milyon çıkış token'ı için ise 6 dolar olarak ücretlendiriliyor. Cache hit’leri ise 0,50 dolara indirimli devam ederken, 500.000 token’lık context penceresi Grok 4.6’da olduğu gibi korundu.
Ancak model, her yanıt için çok daha fazla işlem yapıyor. Artificial Analysis, her Endeks görevi başına ortalama 81.000 çıkış token’ı kullanıldığını, Grok 4.6’da bu rakamın 36.000, GPT-6 Astra’da ise 27.000 olduğunu tespit etti. Bu yüzden birim başı token fiyatı sabit kalsa da, her görev için fatura önemli ölçüde artıyor.
Bu yüksek token iştahı ise, geçtiğimiz dönemde 1,26 milyar dolar zarar açıklayan birime yük oluyor. Bu arada Musk, 14 eylül'de Grok 4.8’in eğitim sürecinin bir hafta içinde tamamlanacağını belirtti.
Ayrıca Musk, Grok 5’in yapay genel zekâya ulaşan model olmasını bekliyor. Sıradaki güncelleme, SpaceXAI’nin sıralamada daha üst basamaklara ek işlem gücü tüketmeden tırmanıp tırmanamayacağını gösterecek.
YouTube kanalımıza abone olun ve uzmanlardan sektöre dair analizleri ilk siz izleyin
https://youtu.be/IcgIaeIE7LI
Orijinal Elon Musk: Grok 4.7 Her Modeli Geçecek Demişti, Beklenti Karşılandı mı? hikayesini Kamina Bashir tarafından tr.beincrypto.com ’da okuyun