

Anthropic ha appena scoperto qualcosa all’interno dei suoi modelli Claude che nessuno aveva progettato o previsto. Una struttura interna chiamata "J-space" sembra funzionare come uno spazio di lavoro cognitivo condiviso tra tutto il modello.
La ricerca pubblicata il 6 luglio rappresenta un passo importante verso la comprensione di ciò che accade realmente all’interno dei grandi modelli linguistici.
Che cos’è realmente il J-space all’interno di Claude
Il J-space è un’area interna in cui Claude sembra raccogliere e condividere informazioni rilevanti tra diverse parti del modello. Una maniera semplice per comprenderlo è immaginarlo come una lavagna bianca interna all’AI.
Quando Claude risponde a una domanda, risolve un enigma o segue un’istruzione, i dettagli chiave sembrano comparire in questo spazio condiviso così che le diverse parti del modello possano utilizzarli.
Anthropic ha scoperto il J-space utilizzando uno strumento di ricerca chiamato “J-lens”. Lo strumento aiuta i ricercatori a studiare come le informazioni si muovono all’interno di Claude durante un’attività. È emerso che il J-space si è generato spontaneamente durante l’addestramento. Anthropic non lo ha progettato in modo diretto.
Seguici su X per ricevere le ultime notizie in tempo reale .
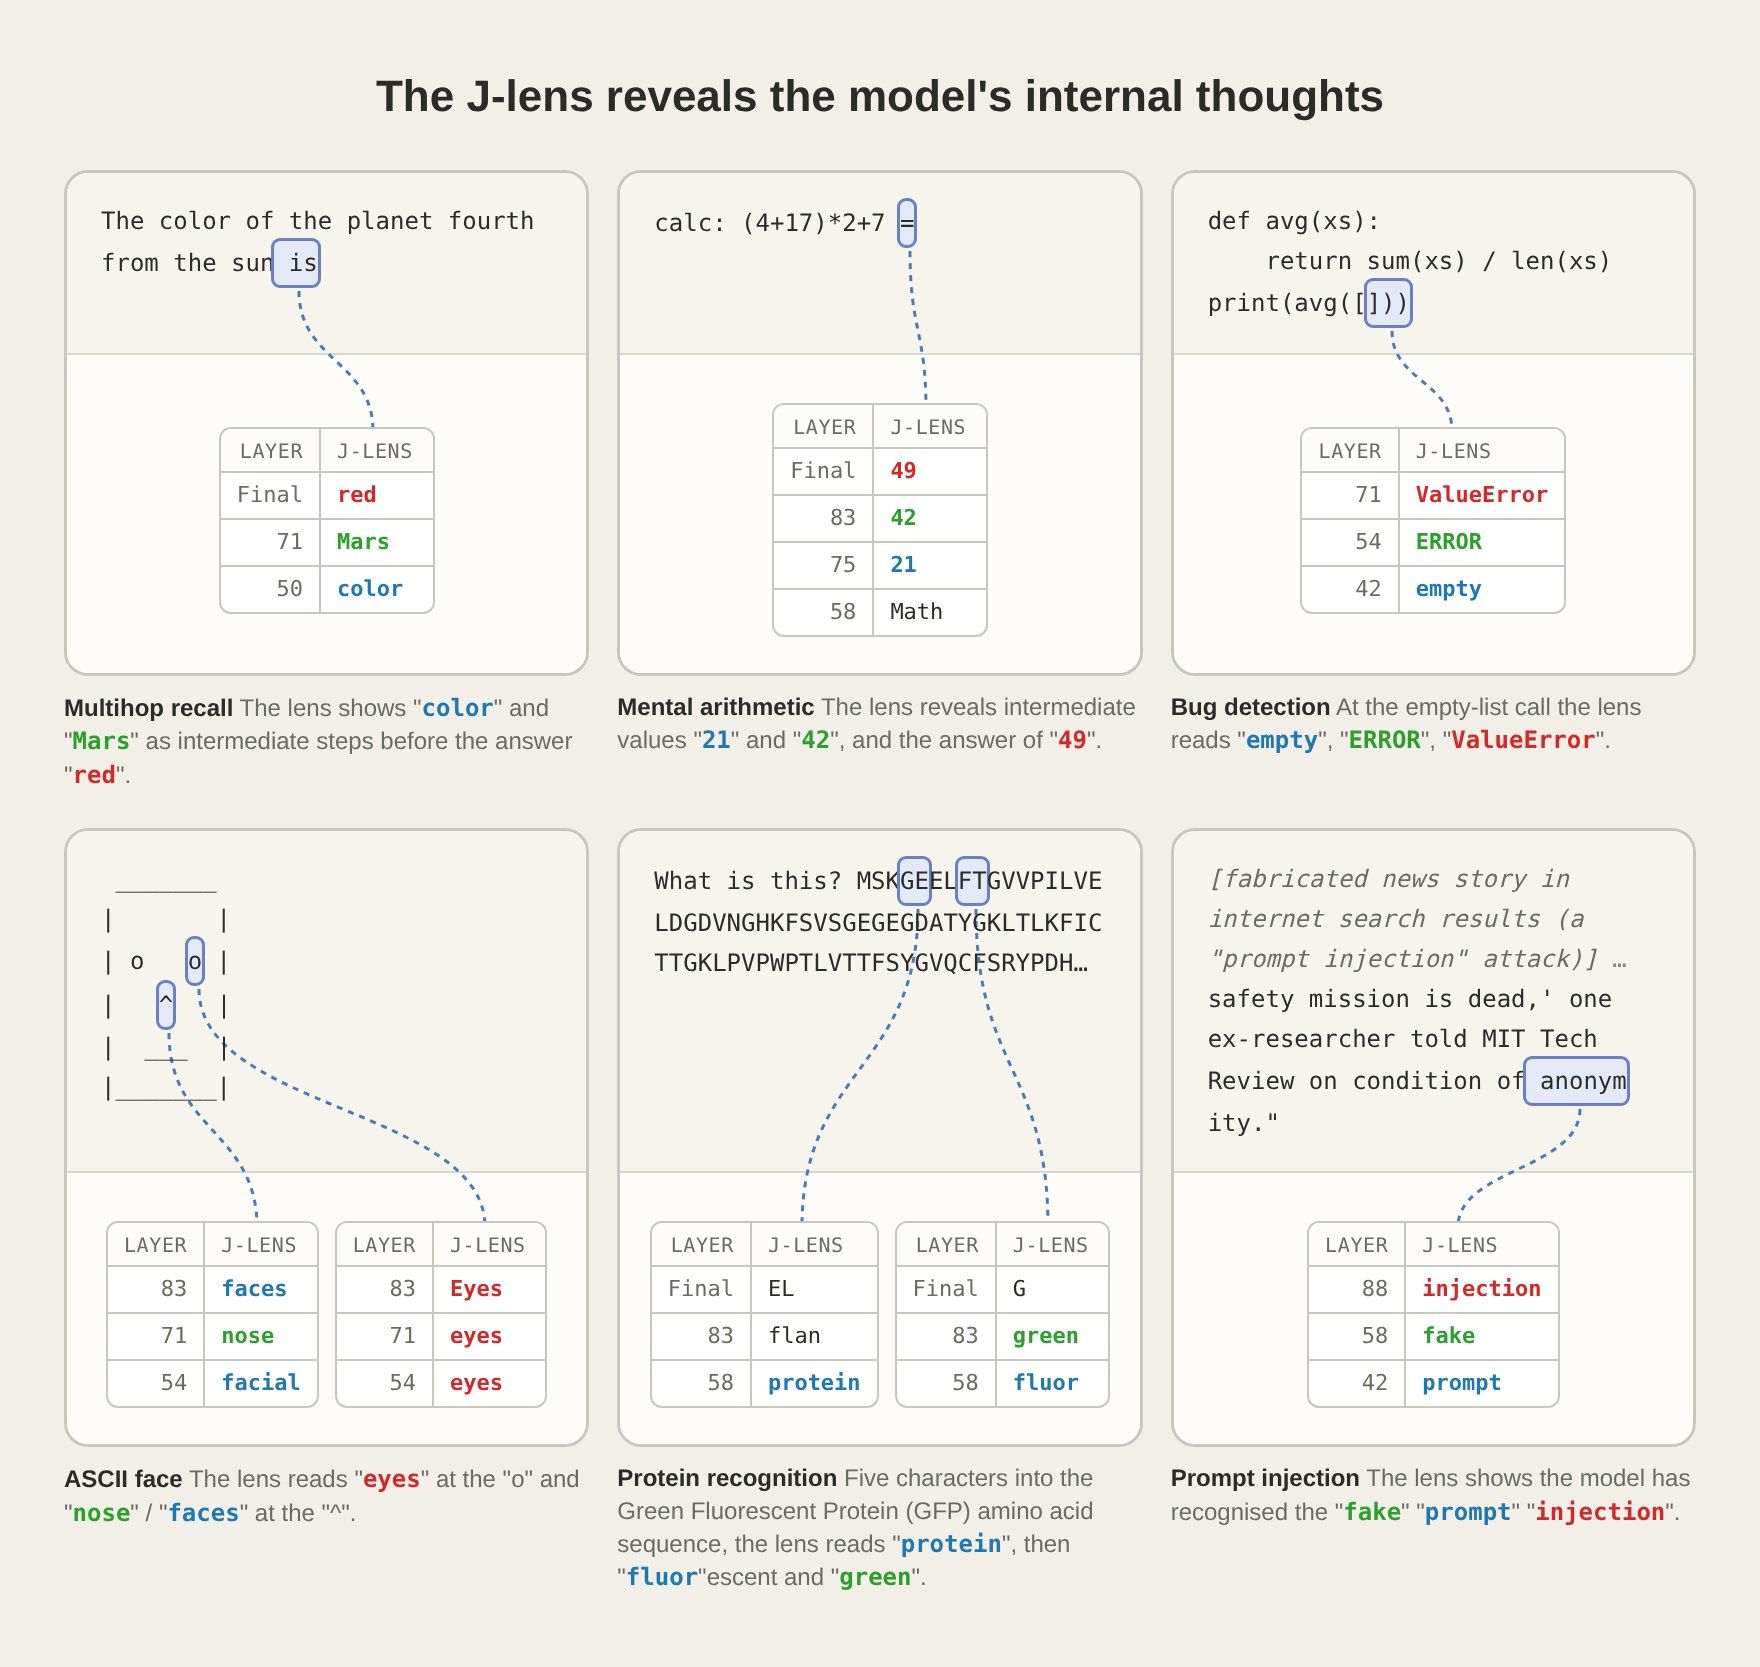 Il J-space di Claude riflette molto da vicino ciò che gli scienziati chiamano "global workspace" nella cognizione umana. Fonte: Anthropic
L'idea è simile a una teoria delle neuroscienze chiamata “global workspace”.
Negli esseri umani, questa teoria spiega come il cervello renda le informazioni importanti disponibili contemporaneamente a diversi processi mentali. Ad esempio, quando una persona ascolta una domanda, ricorda un fatto e decide come rispondere, tutte queste informazioni devono essere integrate.
Anche Claude sembra operare in modo simile. Anthropic ha scoperto che Claude può spiegare in dettaglio cosa si trova nel suo J-space se viene richiesto. Può anche modificare quei contenuti su istruzione.
Ancora più importante, quando i ricercatori hanno modificato direttamente il J-space, anche le risposte e le prestazioni di Claude nei compiti sono cambiate.
This is fascinating for so many reasons, but I am astonished that this legit just *emerged*
— spor (@sporadica) July 6, 2026
it wasn't coded or programmed or anything, it just so happens that it when training a large language model, a small internal "consciously accessible" workspace of sorts emerges.....HUH https://t.co/AJzwH8gfxI pic.twitter.com/f7qORNOLir
Perché questa scoperta è importante per la sicurezza e l'interpretabilità dell'AI
La scoperta ha un impatto reale sulla sicurezza dell’AI. Se i ricercatori potessero monitorare l’attività del J-space, potrebbero potenzialmente scoprire motivazioni nascoste dietro il comportamento del modello. Di conseguenza, disporrebbero di uno strumento più efficace per individuare quando qualcosa non va.
Ciò comprende anche la rilevazione degli attacchi. Monitorare il J-space potrebbe rivelare quando il modello processa un tentativo di prompt-injection pensato per alterare i suoi output. Inoltre, anche avere parzialmente una finestra su questo livello di "processamento conscio" rappresenta un progresso significativo per il settore.
Rimane comunque un limite importante. La stragrande maggioranza dell’elaborazione delle informazioni di Claude avviene ancora completamente al di fuori del J-space.
Anthropic ha comunque rilasciato una versione open source di J-lens e una demo Neuronpedia, invitando la più ampia comunità di ricerca a testare i risultati.
Iscriviti al nostro canale YouTube per ascoltare esperti e giornalisti che forniscono approfondimenti di settore .
https://www.youtube.com/watch?v=rKV5JcALQoQQuesto lavoro si basa su una lunga serie di studi. Anthropic ha pubblicato un report sulla consapevolezza introspettiva emergente nell’ottobre 2025. Inoltre, ha lanciato iniziative per il benessere dei modelli nell’aprile 2025, continuando ad approfondire ciò che accade nei suoi sistemi.
C’è però una precisazione fondamentale. Anthropic sottolinea che la ricerca non afferma che Claude sia cosciente o abbia un’esperienza soggettiva. Nel paper si usa l’espressione “informazione coscientemente accessibile”, prendendo in prestito il termine senza sostenere che il modello sia effettivamente cosciente.
Leggi la storia originale Claude AI ha creato qualcosa che Anthropic non aveva mai progettato di Luis Blanco su it.beincrypto.com