

イーサリアム共同創業者のヴィタリック・ブテリン氏は、ローカル生成AIが日常業務の大部分を担う段階に近づいていると述べた。同氏はアリババの「Qwen3.8-Flash-Next」を自身のノートパソコン上で動作させ、その速度結果を公開した。
ChatGPTと異なり、この仕組みではクラウドサーバーに一切接続しない。モデルはパソコン本体に搭載され、端末のみで応答処理を完結する。
ブテリン氏のローカルAIテスト、実用的な速度を確認
使用したノートパソコンにはAMDの「Strix Halo」チップを搭載。通常のパソコンではプロセッサと独立したグラフィックスカードが分かれて作業し、それぞれが独自のメモリ領域を持つ。Strix Haloは両者を1枚のシリコン基板上に統合し、1つのメモリプールを共有させる設計。
この設計が重要となるのは、AIモデルは実行前にメモリに収まる必要があるため。一般的なグラフィックスカードのメモリは8〜24ギガバイトにとどまるが、このサイズのモデルには不十分。Strix Halo搭載のパソコンは最大128ギガバイトを両機能が利用可能。1台のノートパソコンで従来サーバー専用だったモデルの運用を実現する。
公開された速度は日常業務に十分な水準。短いプロンプトへの応答は読みやすいペースで返ってきた。ただし、プロンプトが数万語規模になると出力は低下し、非常に長い文書は依然として弱点。
アリババは8月26日にオープンウエイトを公開。開発チームによると、モデルは1,250億のパラメータを持つが、一度に活性化するのは60億で、メモリ負荷を抑えている。
ブテリン氏はこのモデルに「Qwen3.8-Flash」と命名したが、アリババがダウンロード配布する名称は「Qwen3.8-Flash-Next」。より大型のモデル「Qwen3.8-Max」は8月に高いベンチマークスコアを記録した。
Vitalik Buterin. Source: XQwen 3.8 flash is truly impressive, and llama.cpp has been rapidly getting better and better at processing it
— vitalik.eth (@VitalikButerin) September 17, 2026
columns are: pre-existing prompt, new prompt, generated, input tok/s, output tok/s
This is on my laptop (strix halo). I think we're very close to the point where you… pic.twitter.com/v5Ze4Fv5Wr
なぜプライバシーで計算式が変わるのか
ブテリン氏は、単なる処理速度にとどまらない利点も指摘する。ローカルモデルは端末内で完結するため、プロバイダーがリクエストを受け取ることがない。
高負荷な作業には分担案を提案。ローカルモデルで処理できる範囲は自身で、それ以外は機微な部分を除去したうえで外部クラウドに投げる形を想定する。
「ローカルモデルを使って強力なモデルへのクエリを制御すれば、個人情報が漏洩しなくなる」
実際には、ローカルモデルがプロンプトから氏名やウォレットアドレス、秘匿コードなどを抽出し、残る部分のみを外部に送信。こうしたフィルターで端末からの流出を最小化する。ただし、すべての機微情報の流出防止は保証できない。
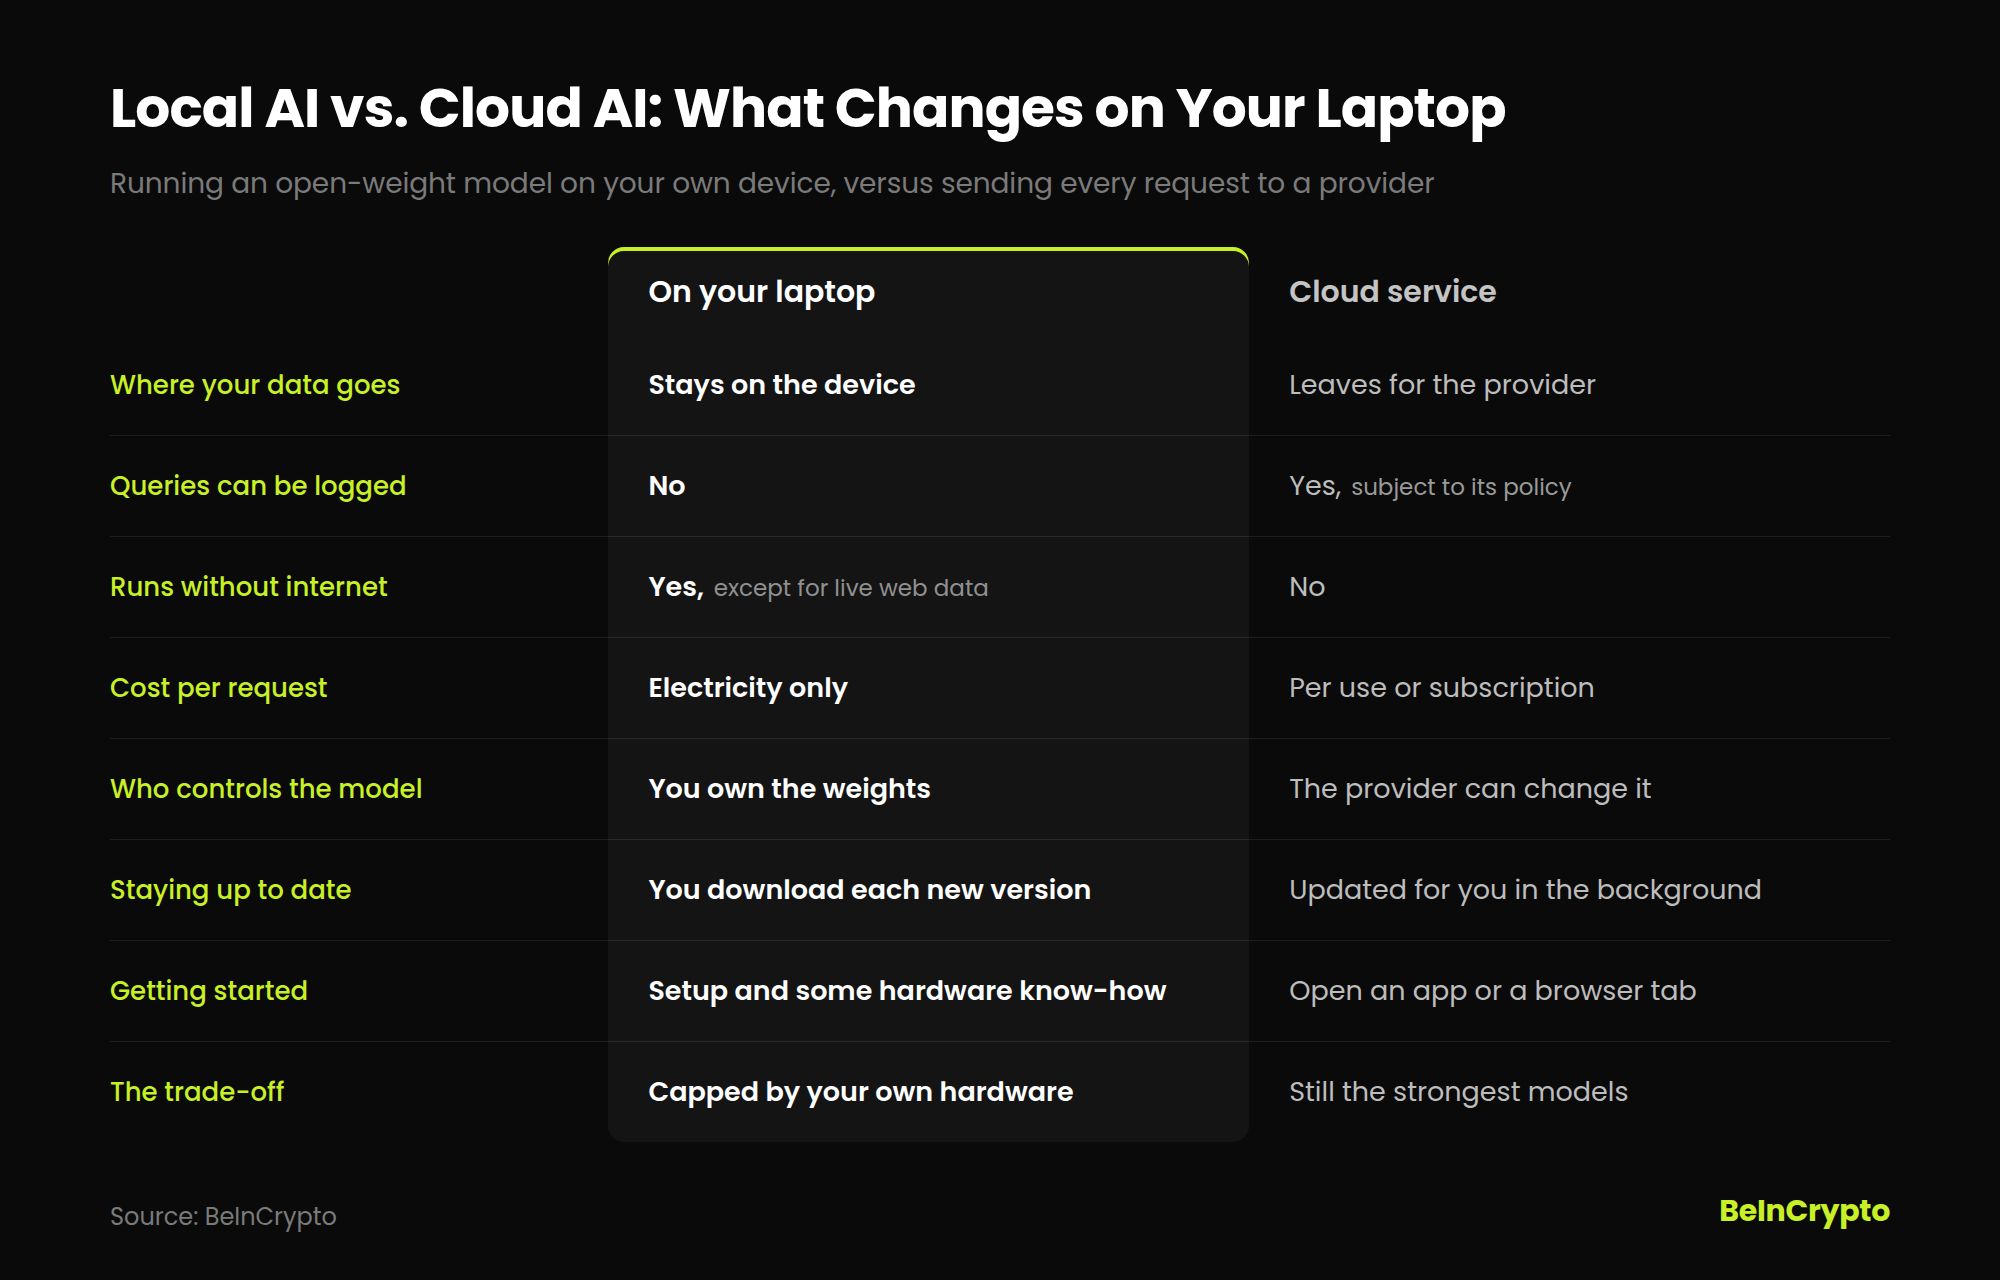 ローカルAIとクラウドサービスの比較グラフィック 出典:BeInCrypto
こうした主張は、同氏の実績に沿う。EUチャット規制論争では監視リスクを警告し、暗号資産ユーザーからも同様の理由でAIエージェント規制強化を求める声があがっている。
5月に提訴された集団訴訟では、OpenAIがChatGPTのユーザー質問をMetaやGoogleと共有していたと非難されている。
依然としてクラウドサービスが最先端を担う。ただ、ローカル処理の進歩で日常業務の多くがサーバー外へ移行し、安価な共有メモリ型ハードウェアの普及が続く。
利用者は今後、どこまで機能と制御権のトレードオフを許容するかが問われる。
jp.beincrypto.com でPhil Haunhorstによるオリジナル記事 ヴィタリック・ブテリン氏のローカルAI推進 パソコンでChatGPT代替可能か を読む