В этой статье мы рассмотрим использование трейлинг-стопа в торговле — насколько он полезен и эффективен, и как его можно использовать. Эффективность трейлинг-стопа во многом зависит от волатильности цены и подбора уровня стоп-лосса. Для установки стоп-лосса могут использоваться самые разные подходы.
Предлагаю Вам познакомиться с довольно эффективным методом многоагентного прогнозирования траекторий, который способен адаптироваться к различным состояниям окружающей среды.
Различных торговых стратегий существует довольно много. С точки зрения диверсификации рисков и повышения устойчивости торговых результатов может оказаться полезным использовать несколько параллельно работающих стратегий. Но если каждая стратегия будет реализована в виде отдельного советника, то управлять их совместной работой на одном торговом счёте становится гораздо сложнее. Для решения этой проблемы желательно реализовать работу разных торговых стратегий в одном советнике.
Мы продолжаем рассмотрение алгоритмов обучения моделей прогнозирования траекторий. И в данной статье я предлагаю вам познакомиться с методом под названием “AutoBots”.
При создании любой торговой системы есть задача, которую необходимо эффективно решить. Эта задача заключается в выставлении ордеров либо в их автоматической обработке торговой системой. В статье рассмотрено создание торговой системы с точки зрения эффективного выставления ордеров.
Качество прогнозирование будущих состояний играет важную роль в метода Goal-Conditioned Predictive Coding, с которым мы познакомились в предыдущей статье. В данной статье я хочу познакомить Вас с алгоритмом, способным значительно повысить качество прогнозирования в стохастических средах, к которым можно отнести и финансовые рынки.
В предыдущих работах мы познакомились с методом Decision Transformer и несколькими производными от него алгоритмами. Мы экспериментировали с различными методами постановки цели. В процессе экспериментов мы работали с различными способами постановки целей, однако изучение моделью уже пройденной траектории всегда оставалось вне нашего внимания. В данной статье я хочу познакомить Вас с методом, который заполняет этот пробел.
В этой статье мы предлагаем познакомиться с алгоритмом, который использует операторы улучшения политики в закрытой форме для оптимизации действий Агента в офлайн режиме.
В оффлайн обучении мы используем фиксированный набор данных, что ограничивает покрытие разнообразия окружающей среды. В процессе обучения наш Агент может генерировать действия вне этого набора. При отсутствии обратной связи от окружающей среды корректность оценок таких действий вызывает вопросы. Поддержание политики Агента в пределах обучающей выборки становится важным аспектом для обеспечения надежности обучения. Об этом мы и поговорим в данной статье.
С первых статей, посвященных обучению с подкреплением, мы так или иначе затрагиваем 2 проблемы: исследование окружающей среды и определение функции вознаграждения. Последние статьи были посвящены проблеме исследования в офлайн обучении. В данной статье я хочу Вас познакомить с алгоритмом, авторы которого полностью отказались от функции вознаграждения.
В данной статье мы продолжим разговор о методах сбора данных в обучающую выборку. Очевидно, что в процессе обучения необходимо постоянное взаимодействие с окружающей средой. Но ситуации бывают разные.
Разбираем вопрос, что такое количественный анализ, как его применяют крупные игроки, создадим один из алгоритмов количественного анализа на языке MQL5.
Под мультивалютным советником в этой статье понимается советник, или торговый робот, который может торговать (открывать/закрывать ордера, управлять ордерами и т. д.) более чем одной парой символов с одного графика.
Обучение моделей в офлайн режиме осуществляется на данных ранее подготовленной обучающей выборки. Это дает нам ряд преимуществ, но при этом информация об окружающей среде сильно сжимается до размеров обучающей выборки. Что, в свою очередь, ограничивает возможности исследования. В данной статье хочу предложить познакомиться с методом, позволяющем наполнить обучающую выборку максимально разнообразными данными.
Эта статья является вводной для целого цикла статей о программировании. Здесь предполагается, что читатель вообще не сталкивался с программированием раньше. Поэтому начинаю я с самых основ. Уровень знания программирования: абсолютный новичок.
В результате тестов, проведенных в предыдущих статьях, мы пришли к выводу, что оптимальность обученной стратегии во многом зависит от используемой обучаемой выборки. В данной статье я предлагаю вам познакомиться с довольно простым и эффективном методе выбора траекторий для обучения моделей.
Продолжаем рассмотрение семейства методов Трансформера решений. Из предыдущих работ мы уже заметили, что обучение трансформера, лежащего в основе архитектуры данных методов, довольно сложная задача и требует большого количества размеченных обучающих данных. В данной статье мы рассмотрим алгоритм использования не размеченных траекторий для предварительного обучения моделей.
В последних статьях мы познакомились с несколькими вариантами использования метода Decision Transformer. Который позволяет анализировать не только текущее состояние, но и траекторию предшествующих состояний и, совершенных в них, действий. В данной статье я предлагаю Вам познакомиться с вариантом использования данного метода в иерархических моделях.
В этой статье мы объясним, как разработать показатель качества, который ваш советник сможет отображать в тестере стратегии. Мы познакомимся с двумя известными методами расчета (Ван Тарп и Санни Харрис).
В процессе офлайн обучения мы оптимизируем политику Агента по данным обучающей выборки. Полученная стратегия придает Агенту уверенность в его действиях. Однако такой оптимизм не всегда оправдан и может привести к увеличению рисков в процессе эксплуатации модели. Сегодня мы рассмотрим один из методов снижения этих рисков.
В статье рассмотрим принципы создания мультисимвольных мультипериодных индикаторов и получение от них данных в советниках и индикаторах. Рассмотрим основные нюансы использования мульти-индикаторов в советниках и индикаторах, и их отрисовку через буферы пользовательского индикатора.
Примеры передачи индикаторов в перцептрон. В статье даются общие понятия, представлен простейший готовый советник, результаты его оптимизации и форвард тестирования.
Последние 2 статьи были посвящены методу Decision Transformer, который моделирует последовательности действий в контексте авторегрессионной модели желаемых вознаграждений. В данной статье мы рассмотрим ещё один алгоритм оптимизации данного метода.
В предыдущей статье мы познакомились с Трансформером решений. Но сложная стохастическая среда валютного рынка не позволила в полной мере раскрыть потенциал представленного метода. Сегодня я хочу представить Вам алгоритм, который направлен на повышение производительности алгоритмов в стохастических средах.
Мы продолжаем рассмотрение методов обучения с подкреплением. И в данной статье я предлагаю вам познакомиться с несколько иным алгоритмом, который рассматривает политику Агента в парадигме построения последовательности действий.
В этой статье мы кратко рассмотрим библиотеку численного анализа ALGLIB 3.19, ее приложения и новые алгоритмы, позволяющие повысить эффективность анализа финансовых данных.
Старые торговые стратегии. В этой статье представлена стратегия отслеживания тренда. Стратегия исключительно техническая и использует несколько индикаторов и инструментов для подачи сигналов и определения целевых уровней. Компоненты стратегии включают в себя: 14-периодный стохастический осциллятор, пятипериодный стохастический осциллятор, скользящую среднюю с периодом 200 и проекцию Фибоначчи (для установки целевых уровней).
Комбинации стратегий могут повысить эффективность торговли. Мы можем комбинировать индикаторы и паттерны, чтобы получать дополнительные подтверждения. Скользящие средние помогают нам подтвердить тренд и следовать ему. Это самые известный технический индикатор, что объясняется его простотой и доказанной эффективностью анализа.
В этой справочной статье рассмотрим стандартные индикаторы из категории "Трендовые индикаторы". Создадим готовые к применению шаблоны использования этих индикаторов в советниках — объявление и установка параметров, инициализация и деинициализация индикаторов и получение данных и сигналов из индикаторных буферов в советниках.
В статье рассмотрим стандартные индикаторы из категории Объемов и индикаторов Билла Вильямса. Создадим готовые к применению шаблоны использования индикаторов в советниках — объявление и установка параметров, инициализация, деинициализация индикаторов и получение данных и сигналов из индикаторных буферов в советниках.
Предлагаем познакомиться с довольно новым алгоритмом Stochastic Marginal Actor-Critic (SMAC), который позволяет строить политики латентных переменных в рамках максимизации энтропии.
Статья является частью серии о реализации графов средствами теории категорий в MQL5 и посвящена отношению порядка (Order Theory). Мы рассмотрим два основных типа упорядочения и исследуем, как концепции отношения порядка могут поддерживать моноидные множества при принятии торговых решений.
Статья продолжает серию о реализации теории категорий в MQL5. Здесь мы рассмотрим, как теория графов может быть интегрирована с моноидами и другими структурами данных при разработке стратегии закрытия торговой системы.
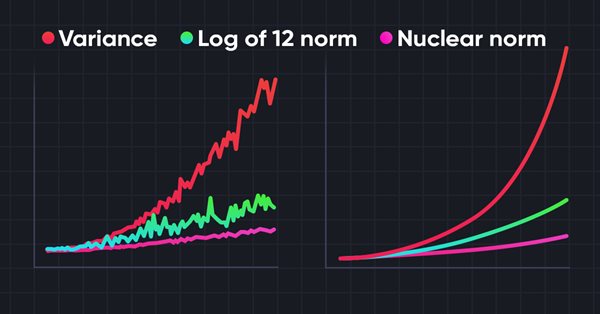
Исследование окружающей среды в задачах обучения с подкреплением является актуальной проблемой. Ранее мы уже рассматривали некоторые подходы. И сегодня я предлагаю познакомиться с ещё одним методом, основанным на максимизации ядерной нормы. Он позволяет агентам выделять состояния среды с высокой степенью новизны и разнообразия.
В этой статье я покажу первую часть доработок, которые позволили мне не только замкнуть всю цепочку автоматизации для торговли в MetaTrader 4 и 5, но и сделать что-то гораздо интереснее. Отныне данное решение позволяет мне полностью автоматизировать как процесс создания советников, так и процесс оптимизации, а также минимизировать трудозатраты на поиск эффективных торговых конфигураций.
Контрастное обучение (Contrastive learning) - это метод обучения представлению без учителя. Его целью является обучение модели выделять сходства и различия в наборах данных. В данной статье мы поговорим об использовании подходов контрастного обучения для исследования различных навыков Актера.
Каждый раз, при рассмотрении методов обучения с подкреплением, мы сталкиваемся с вопросом эффективного исследования окружающей среды. Решение данного вопроса часто приводит к усложнению алгоритма и обучению дополнительных моделей. В данной статье мы рассмотрим альтернативный подход к решению данной проблемы.
Мы уже не раз говорили о важности правильного подбора функции вознаграждения, которую используем для стимулирования желательного поведения Агента, добавляя вознаграждения или штрафы за отдельные действия. Но остается открытым вопрос о дешифровке наших сигналов Агентом. В данной статье мы поговорим о декомпозиции вознаграждения в части передачи отдельных сигналов обучаемому Агенту.