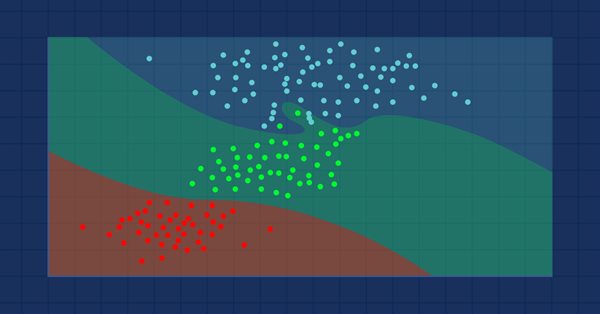
Это ленивый алгоритм, который не учится на обучающей выборке, а хранит все доступные наблюдения и классифицирует данные сразу же, как только получает новую выборку. Несмотря на простоту, этот метод используется во множестве реальных приложений.
Как вам идея добавить новый тип графика в платформу MetaTrader 5? Многие говорят, что в ней не хватает несколько вещей, которые есть в других платформах. Но на самом деле MetaTrader 5 — очень практичная платформа, которая позволяет делать то, что невозможно сделать во многих других платформах, или по крайней мере, в них это сделать не так легко.
Рассмотрим метод оптимизации "Поиск с помощью светлячкового алгоритма" (FA). Из аутсайдера путем модификации алгоритм превратился в настоящего лидера рейтинговой таблицы.
Поиск косяком рыб (FSS) — новый современный алгоритм оптимизации, вдохновленный поведением рыб в стае, большинство из которых, до 80%, плавают организовано в сообществе сородичей. Доказано, что объединения рыб играют важную роль в эффективности поиска пропитания и защиты от хищников.
Следующий алгоритм, который рассмотрим — оптимизация поиском кукушки с использованием полётов Леви. Это один из новейших алгоритмов оптимизации и новый лидер в рейтинговой таблице.
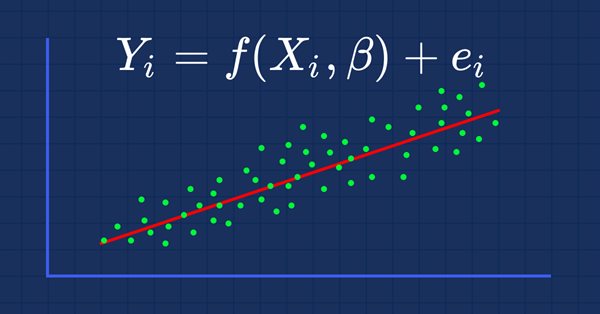
Полиномиальная регрессия — это гибкая модель, предназначенная для эффективного решения задач, с которыми не справляется модель линейной регрессии. В этой статье узнаем, как создавать полиномиальные модели на MQL5 и извлекать из них выгоду.
Рассмотрим один из новейших современных алгоритмов оптимизации "Стаи серых волков". Оригинальное поведение на тестовых функциях делает этот алгоритм одним из самых интересных среди рассмотренных ранее. Один из лидеров для применения в обучении нейронных сетей, гладких функций с многими переменными.
Продолжаем изучение алгоритмов распределенного Q-обучения. В предыдущих статьях мы рассмотрели алгоритмы распределенного и квантильного Q-обучения. В первом мы учили вероятности заданных диапазонов значений. Во втором учили диапазоны с заданной вероятностью. И в первом, и во втором алгоритме мы использовали априорные знания одного распределения и учили другое. В данной статье мы рассмотрим алгоритм, позволяющей модели учить оба распределения.
Сегодня изучим алгоритм искусственной пчелиной колонии. Дополним наши знания новыми принципами исследования функциональных пространств. В данной статье я расскажу о моей интерпретации классического варианта алгоритма.
Эта статья о том, чего вы не найдете в отчете о тестировании, чего следует ожидать при использовании советников, как управлять своими деньгами при использовании роботов и как покрыть значительный убыток, чтобы остаться в трейдинге при автоматизированной торговле.
В предыдущей статье мы начали изучать нейросети с прямой связью, однако остались неразобранными некоторые моменты. Один из них — проектирование архитектуры. Поэтому в этой статье мы рассмотрим, как спроектировать гибкую нейронную сеть с учетом входных данных, количества скрытых слоев и узлов для каждой сети.
Многие любят, но немногие понимают все операции, лежащие в основе нейронных сетей. В этой статье я постараюсь простым языком объяснить все, что происходит за закрытыми дверями многоуровневого перцептрона с прямой связью Feed Forward.
В данной статье рассмотрим популярный алгоритм "Рой Частиц" (PSO — particle swarm optimisation). Ранее мы обсудили такие важные характеристики алгоритмов оптимизации как сходимость, скорость сходимости, устойчивость, масштабируемость, разработали стенд для тестирования, рассмотрели простейший алгоритм на ГСЧ.
Для решения математических задач в MQL5 были добавлены матрицы и векторы. Новые типы имеют встроенные методы для написания краткого и понятного кода, который близок к математической записи. Массивы — это хорошо, но матрицы во многих случаях лучше.
Продолжаем изучение обучения с подкреплением. И в этой статье мы познакомимся с методом глубокого Q-обучения. Использование данного метода позволило команде DeepMind создать модель, способную превзойти человека при игре в компьютерные игры Atari. Думаю, будет полезно оценить возможности подобной технологии для решения задач трейдинга.
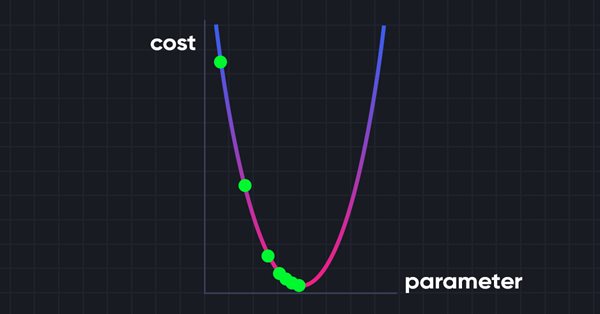
Градиентный спуск играет важную роль в обучении нейронных сетей и различных алгоритмов машинного обучения — это быстрый и умный алгоритм. Однако несмотря на его впечатляющую работу, многие специалисты по данным все еще неправильно его понимают. Давайте в этой статье посмотрим, о чем идет речь.
Продолжаем изучение методов машинного обучения. Данной статьей мы начинаем еще одну большую тему "Обучение с подкреплением". Данный подход позволяет моделям выстаивать определенные стратегии для решения поставленных задач. И мы рассчитываем, что это свойство обучения с подкреплением откроет перед нами новые горизонты построения торговых стратегий.
В данной статье я покажу вам, как считать полную прибыль или убыток любого трейда, включая комиссию и своп. Составим точнейшую математическую модель, напишем по ней код и сравним ее с эталоном, а также попытаемся залезть под капот основной функции MQL5 для вычисления прибыли и докопаемся до сути всех необходимых величин из спецификации.
В последних двух статьях мы создали инструмент, позволяющий создавать и редактировать модели нейронных сетей. И теперь пришло время оценить потенциальные возможности использования технологии Transfer Learning на практических примерах.
Деревья решений классифицируют данные, имитируя то, каким образом размышляют люди. В этой статье посмотрим, как строить деревья и использовать их для классификации и прогнозирования данных. Основная цель алгоритма деревьев решений состоит в том, чтобы разделить выборку на данные с "примесями" и на "чистые" или близкие к узлам.
Современный трейдер почти всегда сознательно или бессознательно находится в поиске новых идей. Он постоянно пробует новые стратегии, модифицирует их и отбрасывает те, что не оправдали себя. Этот исследовательский процесс требует много времени и сопряжен с ошибками. В этой серии статей я постараюсь доказать, что Мастер MQL5 является настоящей опорой трейдера. Благодаря Мастеру, трейдер экономит время при реализации своих идей. Кроме того, снижается вероятность ошибок, возникающих при дублировании кода. Вместо того чтобы тратить время на оформление кода, трейдеры претворяют в жизнь свою торговую философию.
Вводная статья об алгоритмах оптимизации (АО). Классификация. В статье предпринята попытка создать тестовый стенд (набор функций), который послужит в дальнейшем для сравнения АО между собой, и, даже, возможно, выявления самого универсального алгоритма из всех широко известных.
В этой статье я попытаюсь использовать нашу логистическую модель, чтобы спрогнозировать крах фондового рынка на основе главнейших акций для экономики США: NETFLIX и APPLE. Мы проанализируем эти акции, будем использовать информацию о предыдущих падениях рынка 2019 и 2020 годов. Посмотрим, как наша модель будет работать в нынешних мрачных условиях.
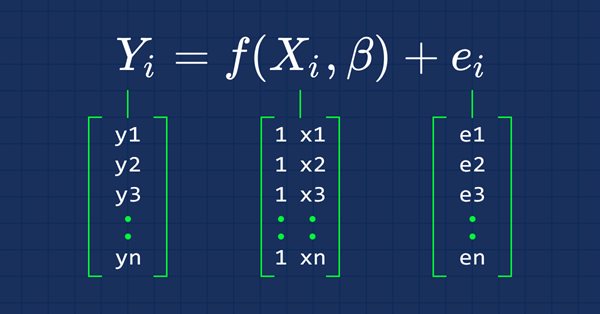
В этот раз мы будем создавать модели с помощью матриц — они дают большую гибкость и позволяют создавать мощные модели, которые могут обрабатывать не только пять независимых переменных, но и множество других, насколько позволяют пределы вычислительных возможностей компьютера. Статья будет очень интересной, это точно.
Мы продолжаем рассмотрение алгоритмов обучения без учителя. И сейчас я предлагаю обсудить особенности использования автоэнкодеров для обучения рекуррентных моделей.
В прошлой статье мы познакомились с алгоритмом работы автоэнкодера. Как и любой другой алгоритм, он имеет свои достоинства и недостатки. В оригинальной реализации автоэнкодер выполняет задачу максимально разделить объекты из обучающей выборки. А о том, как бороться с некоторыми его недостатками мы поговорим в этой статье.
Мы продолжаем изучение алгоритмов обучения без учителя. Возможно, у читателя может возникнуть вопрос об соответствии последних публикаций теме нейронных сетей. В новой статье мы возвращаемся к использованию нейронных сетей.
В этой статье мы продолжим с просмотром того, как получать данные из Интернета для их использования в советнике. Давайте приступим к работе, а точнее к кодированию альтернативной системы.
Выведено уравнение эволюции вероятностного поля цены, найден критерий приближения ценового скачка, раскрыты суть ценовых значений на графиках котировок и механизм возникновения случайного блуждания этих значений.
Знание того, как вводить данные из Web в советник, не так очевидно, вернее, не так просто, чтобы это можно было сделать без понимания всех возможностей, которые есть в MetaTrader 5.
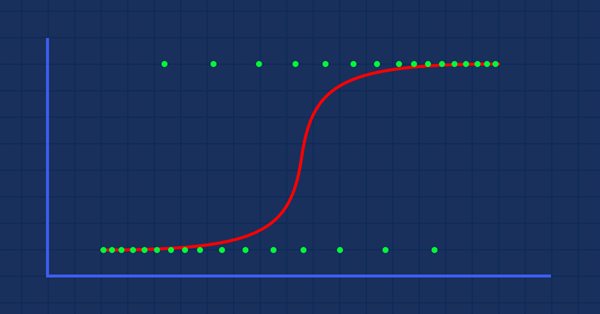
Классификация данных — важнейшая вещь для алготрейдера и программиста. В этой статье мы рассмотрим в подробностях один из классификационных логистических алгоритмов, который может помочь нам определить «да» или «нет», рост или падение, покупки или продажи.
Как получить доступ к данным в Интернете в MetaTrader 5. В Интернете у нас есть различные сайты и места, с огромным количеством информации, доступной для тех, кто знает, где искать и как лучше всего использовать эту информацию.
Продолжаем тему поиска ассоциативных правил. В предыдущей статье мы рассмотрели теоретические аспекты данного типа задач. В этой статье я продемонстрирую реализацию метода FP-Growth средствами MQL5. А также мы протестируем нашу реализацию на реальных данных.
В продолжение данной серии статей предлагаю познакомиться ещё с одним типом задач из методов обучения без учителя — поиск ассоциативных правил. Данный тип задач впервые был применен в ритейле для анализа корзин покупателей. О возможностях использования подобных алгоритмов в рамках трейдинга мы и поговорим в этой статье.
Метамодели в машинном обучении: Автоматическое создание торговых систем практически без участия человека — Модель сама принимает решение как торговать и когда торговать.
Мы продолжаем рассмотрение моделей искусственного интеллекта. И, в частности, алгоритмов обучения без учителя. Мы уже познакомились с одним из алгоритмов кластеризации. А в этой статье я хочу поделиться с Вами вариантом решения задач понижения размерности.
Представлены основы математически строгой теории движения цены и функционирования рынка. Строгой математической теории движения цены до настоящего момента еще не было создано, а имелся только ряд неподкрепленных ни статистикой, ни теорией предположений типа, что после таких-то паттернов цена движется так-то.
В предыдущей статье мы построили класс для кластеризации данных. В этой статье я хочу с вами поделиться вариантами возможного использования полученных результатов для решения практических задач трейдинга.