Continuamos a estudar os algoritmos de aprendizado Q distribuído. Em artigos anteriores, já discutimos os algoritmos de aprendizado Q distribuído e de quantil. No primeiro, aprendemos as probabilidades de determinados intervalos de valores. No segundo, aprendemos intervalos com uma probabilidade específica. Em ambos os algoritmos, utilizamos o conhecimento prévio de uma distribuição e ensinamos a outra. Neste artigo, vamos examinar um algoritmo que permite que o modelo aprenda ambas as distribuições.
Continuamos a explorar algoritmos de aprendizado por reforço. Todos os algoritmos que analisamos até agora exigiam a criação de uma política de recompensa de tal forma que o agente pudesse avaliar cada uma de suas ações em cada transição de um estado do sistema para outro. No entanto, essa abordagem é bastante artificial. Na prática, existe um intervalo de tempo entre a ação e a recompensa. Neste artigo, proponho que você se familiarize com um algoritmo de aprendizado de modelo capaz de lidar com diferentes atrasos temporais entre a ação e a recompensa.
Um novo artigo em nossa série sobre como aprender a desenvolver um sistema de negociação baseado nos indicadores técnicos mais populares será sobre o indicador técnico Gator Oscillator e como criar um sistema de negociação por meio de estratégias simples.
Continuamos a estudar o aprendizado Q distribuído e hoje veremos essa abordagem de outro ponto de vista. Falaremos sobre a possibilidade de usar regressão quantílica para resolver o problema de previsão de movimentos de preços.
Para coroar esta sequencia de automação. Vamos complementar o que foi visto no artigo anterior. Este definitivamente mostra como tudo irá se encaixar, fazendo o Expert Advisor, funcionar como um relógio.
Em um dos artigos desta série, já nos iniciamos no método aprendizado Q, que calcula a média da recompensa para cada ação. Em 2017, foram apresentados 2 trabalhos simultâneos, que tiveram sucesso quanto ao estudo da função de distribuição de recompensas. Vamos considerar a possibilidade de usar essa tecnologia para resolver nossos problemas.
Aqui vamos realmente colocar todo o conhecimento desta sequencia em prática. Vamos finalmente construir um sistema 100% automático e funcional. Mas para fazer isto, você terá que aprender uma última coisa.
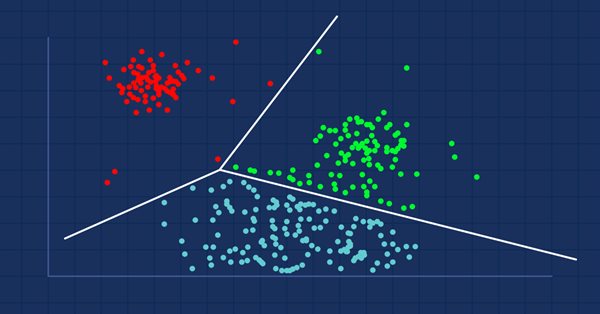
A mineração de dados é crucial para um cientista de dados e um trader porque, muitas vezes, os dados não são tão diretos quanto pensamos, o olho humano não consegue entender o padrão subjacente menor e as relações no conjunto de dados, talvez o algoritmo K-means pode nos ajudar com isso. Vamos descobrir...
Aqui está um novo artigo da nossa série sobre como projetar um sistema de negociação com base nos indicadores técnicos mais populares. Nós aprenderemos um novo indicador que é o indicador Fractais e aprenderemos como desenvolver um sistema de negociação baseado nele para ser executado na plataforma MetaTrader 5.
Neste artigo, completaremos nossa série sobre como projetar um sistema de negociação baseado no indicador técnico mais popular. Nós aprenderemos como criar um sistema de negociação baseado no indicador Alligator.
Neste artigo, falaremos sobre como trabalhar com os gráficos de linhas mais importantes, como linhas de tendência, suporte e resistência, usando as ferramentas da linguagem MQL5.
Você sabe o que é um Fluxograma ? Sabe como usar ele ? Acha que fluxograma é apenas conversa de programador aprendiz ? Bem, veja este artigo e aprenda como trabalhar com fluxogramas.
Se você acha que sistemas automáticos são simples, significa que você ainda não entendeu de fato o que se deve criar. Vamos aqui ver um problema que mata muito Expert Advisor. O disparo indiscriminado de ordens e uma possível solução para este problema.
Este artigo é sobre o que você não pode ver em um relatório de backtest, o que você deve esperar usando um software de negociação automatizado, como gerenciar seu dinheiro se estiver usando expert advisors e como cobrir uma perda significativa para permanecer na atividade de negociação quando você está usando procedimentos automatizados.
Um sistema automático sem segurança não irá dar certo. Mas segurança não nasce sem que entendamos adequadamente algumas coisas. Neste artigo vamos entender é tão difícil alcançar a segurança máxima em sistemas automáticos.
O trader de hoje é um filomata que está quase sempre procurando novas ideias, experimentando-as, escolhendo modificá-las ou descartá-las; um processo exploratório que deve custar uma quantidade razoável de diligência. Esta série de artigos proporá que o assistente MQL5 deve ser um esteio para os traders.
No último artigo, iniciamos a análise dos métodos de otimização sem gradiente, e nos familiarizamos com o algoritmo genético. Hoje, continuaremos a discutir o mesmo assunto e também examinaremos outra classe de algoritmos evolutivos.
Um novo artigo da nossa série sobre como criar sistemas de negociação simples pelos indicadores técnicos mais populares. Nós aprenderemos sobre o indicador Oscilador Acelerador e aprenderemos como desenvolver um sistema de negociação usando-o.
Hoje quero apresentar-lhes um método de aprendizado um pouco diferente. Pode-se dizer que é emprestado da teoria da evolução de Darwin. É provavelmente menos controlável do que os métodos discutidos anteriormente. Mas, mesmo assim, permite também treinar modelos indiferenciados.
Automação não é nada sem que você consiga controlar o horário. Nenhum trabalhador consegue ser eficiente trabalhando 24 horas. No entanto, muitos acreditam que um sistema automático deva trabalhar 24 horas. Mas é sempre bom que você tenha meios de configurar um range de horário para o Expert Advisor. Neste artigo iremos tratar disto. Como adicionar adequadamente uma faixa de horário.
Nos artigos anteriores desta série, conhecemos 2 algoritmos de aprendizado por reforço. Cada um deles tem suas próprias vantagens e desvantagens. Como costuma acontecer quando nos deparamos com esses casos, surge a ideia de combinar os dois métodos em um algoritmo que incorpore o melhor dos dois. E assim compensar as deficiências de cada um deles. Falaremos sobre tal combinação de métodos neste artigo.
Criar um Expert Advisor automático não é uma tarefa muito complicada. Mas sem o devido conhecimento você pode acabar fazendo muita bobagem. Neste artigo iremos ver como se dá a construção do primeiro nível de automação. Então a questão aqui é aprender a criar o gatilho para promover o Breakeven e o Trailing Stop.
Neste artigo, mostrei como você pode usar o sistema de tratamento de eventos, a fim de conseguir lidar com mais agilidade, e de uma forma melhor com questões envolvendo o sistema de ordens, a fim de deixar o EA mais rápido. Assim ele não precisará, ficar procurando informações a todo o momento.
Neste novo artigo da nossa série, nós aprenderemos sobre uma nova ferramenta técnica que pode ser útil em nossas negociações e ele é o indicador Awesome Oscillator (AO). Nós aprenderemos como desenvolver um sistema de negociação por este indicador.
Um novo artigo em nossa série sobre como desenvolver um sistema de negociação pelo indicador técnico mais popular. Neste artigo, nós aprenderemos como fazer isso pelo indicador Índice de Vigor Relativo.
Continuamos a estudar métodos de aprendizado por reforço. No artigo anterior, nos iniciamos no método de aprendizado Q profundo. Com ele, treinamos um modelo para prever a recompensa imediata dependendo da ação tomada por nós em uma determinada situação. E, em seguida, realizamos uma ação de acordo com nossa política e a recompensa esperada. Mas nem sempre é possível aproximar a função Q ou nem sempre sua aproximação dá o resultado desejado. Nesses casos, os métodos de aproximação são usados não para funções de utilidade, mas, sim, para uma política (estratégia) direta de ações. E é precisamente a esses métodos que o gradiente de política pertence.
Aqui está um novo artigo em nossa série sobre como desenvolver um sistema de negociação pelos indicadores técnicos mais populares. Neste artigo, nós apresentaremos como criar um sistema de negociação pelo indicador DeMarker.
Bem-vindo a um novo artigo da nossa série sobre como desenvolver um sistema de negociação pelos indicadores técnicos mais populares, neste artigo aprenderemos sobre uma nova ferramenta técnica e aprenderemos como desenvolver um sistema de negociação pelo Variable Index Dynamic Average (VIDYA).
Há detalhes a serem abordadas na rede neural feed-forward antes de finalizarmos este assunto, a arquitetura é uma delas. Vamos ver como nós podemos construir e desenvolver uma rede neural flexível para as nossas entradas, o número de camadas ocultas e os nós para cada rede.
Aprenda como criar um EA que opera de forma automática, isto de forma simples e o mais seguro possível. É preciso sempre ficar atento, ao que um EA automatizado, esta fazendo, e se ele sair da linha, removê-lo o mais rápido possível do gráfico, encerrando o que ele estava fazendo, a fim de evitar que as coisas fugam do controle.
Bem-vindo a um novo artigo em nossa série sobre como desenvolver um sistema de negociação com base nos indicadores técnicos mais populares, aqui está um novo artigo sobre como aprender a desenvolver um sistema de negociação pelo indicador técnico Bull's Power.
Continuamos nosso estudo sobre aprendizado por reforço. E, neste artigo, vamos nos familiarizar com o método de aprendizado Q profundo. Com esse método, a equipe do DeepMind criou um modelo que pode superar um humano ao jogar jogos do Atari. Acho que será útil avaliar as possibilidades de tal tecnologia para resolver problemas de negociação.
Nos dois últimos artigos, criamos uma ferramenta que permite criar e editar modelos de redes neurais. E agora é hora de avaliar o uso potencial da transferência de aprendizado (transfer learning, em inglês) usando exemplos práticos.
No último artigo, elaboramos uma ferramenta para criar e editar a arquitetura de redes neurais. E hoje quero convidá-lo a continuar trabalhando nela, para torná-la mais amigável. De certa forma, ao fazer isso, estamos nos afastando um pouco do nosso tópico. Mas convenhamos que a organização do espaço de trabalho desempenha um papel importante na obtenção do resultado.
Aprenda como criar um EA que opera de forma automática, isto de forma simples e o mais seguro possível. Nosso EA, até o momento consegue trabalhar, em qualquer tipo de situação, mas para torná-lo automatizado, ele não está adequado, precisamos fazer algumas coisas.
Bem-vindo a um novo artigo em nossa série sobre como desenvolver um sistema de negociação com base nos indicadores técnicos mais populares, aqui está um novo artigo sobre como aprender a desenvolver um sistema de negociação pelo indicador técnico Bear's Power.
Nesta série de artigos, já mencionamos a transferência de aprendizado mais de uma vez. Mas até agora o assunto não foi além das menções. Sugiro preencher essa lacuna e dar uma olhada mais de perto na transferência de aprendizado.
Continuamos a estudar algoritmos de aprendizado não supervisionado. E agora proponho discutir as particularidades por trás do uso de autocodificadores para treinar modelos recorrentes.
As redes neurais são tudo para nós. E vamos verificar na prática se é assim, indagando se MetaTrader 5 é uma ferramenta autossuficiente para implementar redes neurais na negociação. A explicação vai ser simples.
Muitas pessoas as amam, mas apenas alguns entendem todas as operações por trás das Redes Neurais. Neste artigo, eu tentarei explicar tudo o que acontece por trás dos bastidores de um perceptron multicamadas feed-forward de maneira simples.