В этой статье мы продолжим этап разработки симулятора. Однако сейчас мы увидим, как эффективно создать движение типа «СЛУЧАЙНОЕ БЛУЖДАНИЕ». Этот тип движения весьма интригующий, поскольку служит основой всего, что происходит на рынке капитала. Кроме того, мы начнем понимать некоторые концепции, основополагающие для тех, кто проводит анализ рынка.
Здесь мы немного упростим несколько элементов, связанных с работой в следующей статье. Я также объясню, как можно визуализировать то, что генерирует симулятор с точки зрения случайности.
Разработка симулятора может оказаться гораздо интереснее, чем кажется. Сегодня мы сделаем еще несколько шагов в этом направлении, потому что всё становится интереснее.
В статье представлен метод автоматического обнаружения моделей ценовых действий с помощью MQL5, таких как тренды (восходящий, нисходящий, боковой) и графические модели (двойная вершина, двойное дно).
Как разработчикам, нам необходимо научиться создавать и разрабатывать программное обеспечение, которое можно использовать многократно и гибко, без дублирования кода, особенно если у нас есть разные объекты с разным поведением. Это можно легко сделать, используя методы и принципы объектно-ориентированного программирования. В этой статье представлены основы объектно-ориентированного программирования в MQL5.
Существует множество технических инструментов, которые можно использовать для визуализации ценового канала. Одним из таких инструментов является канал Дончиана (Donchian Channel). В этой статье мы узнаем, как создать канал Дончиана и как использовать его в качестве пользовательского индикатора в составе советника.
В этой статье мы рассмотрим парный трейдинг: какие принципы лежат в его основе, есть ли перспективы его применения на практике. Заодно, попробуем создать стратегию парного трейдинга.
Представляю новую статью о том, как создать пользовательский индикатор. На этот раз мы будем работать с индексом истинной силы - True Strength Index (TSI) и создадим советник на его основе.
Предлагаем познакомиться с довольно новым алгоритмом Stochastic Marginal Actor-Critic (SMAC), который позволяет строить политики латентных переменных в рамках максимизации энтропии.
Статья является частью серии о реализации графов средствами теории категорий в MQL5 и посвящена отношению порядка (Order Theory). Мы рассмотрим два основных типа упорядочения и исследуем, как концепции отношения порядка могут поддерживать моноидные множества при принятии торговых решений.
Для того, чтобы использовать данные, формирующие бары, мы должны отказаться от репликации и заняться разработкой симулятора. Мы будем использовать 1-минутные бары именно потому, что они предлагают минимальный уровень сложности.
Статья продолжает серию о реализации теории категорий в MQL5. Здесь мы рассмотрим, как теория графов может быть интегрирована с моноидами и другими структурами данных при разработке стратегии закрытия торговой системы.
Здесь мы увидим, как активировать пользовательские события и проработать вопрос о том, как индикатор сообщает о состоянии сервиса репликации/моделирования.
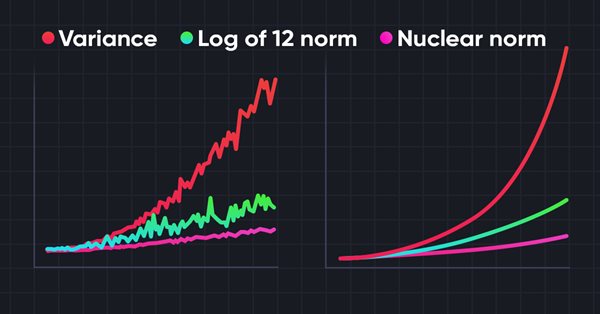
Исследование окружающей среды в задачах обучения с подкреплением является актуальной проблемой. Ранее мы уже рассматривали некоторые подходы. И сегодня я предлагаю познакомиться с ещё одним методом, основанным на максимизации ядерной нормы. Он позволяет агентам выделять состояния среды с высокой степенью новизны и разнообразия.
Контрастное обучение (Contrastive learning) - это метод обучения представлению без учителя. Его целью является обучение модели выделять сходства и различия в наборах данных. В данной статье мы поговорим об использовании подходов контрастного обучения для исследования различных навыков Актера.
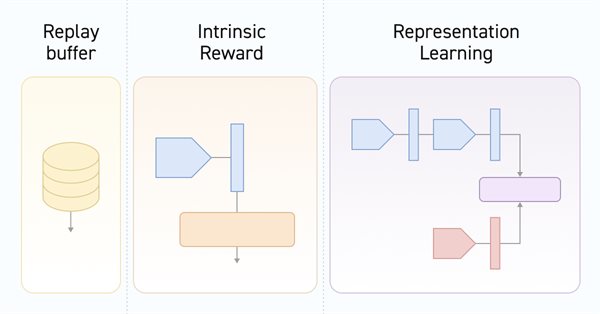
Каждый раз, при рассмотрении методов обучения с подкреплением, мы сталкиваемся с вопросом эффективного исследования окружающей среды. Решение данного вопроса часто приводит к усложнению алгоритма и обучению дополнительных моделей. В данной статье мы рассмотрим альтернативный подход к решению данной проблемы.
Мы уже не раз говорили о важности правильного подбора функции вознаграждения, которую используем для стимулирования желательного поведения Агента, добавляя вознаграждения или штрафы за отдельные действия. Но остается открытым вопрос о дешифровке наших сигналов Агентом. В данной статье мы поговорим о декомпозиции вознаграждения в части передачи отдельных сигналов обучаемому Агенту.
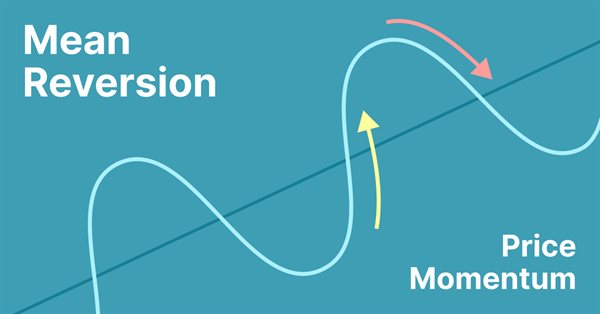
Возврат к среднему - это метод контртрендовой торговли, при котором трейдер ожидает, что цена вернется к некоторой форме равновесия, которое обычно измеряется средним значением или другим статистическим показателем усредненной тенденции.
По мере обучения модели на базе буфера воспроизведения опыта текущая политика Актера все больше отдаляется от сохраненных примеров, что снижает эффективность обучения модели в целом. В данной статье мы рассмотрим алгоритм повышения эффективности использования образцов в алгоритмах обучения с подкреплением.
В последних двух статьях рассматривался алгоритм Soft Actor-Critic, который включает энтропийную регуляризацию в функцию вознаграждения. Этот подход позволяет балансировать исследование среды и эксплуатацию модели, но он применим только к стохастическим моделям. В данной статье рассматривается альтернативный подход, который применим как для стохастических, так и для детерминированных моделей.
В статье я покажу совершенно иной подход к алготрейдингу, к которому мне пришлось прийти спустя достаточно длительное время. Конечно же все это связано с моей брутфорс программой, которая претерпела ряд изменений, которые позволяют ей решать одновременно несколько задач. Тем не менее статья получилась больше общей и максимально простой, по этому годится и для тех кто не в теме или просто проходил мимо.
В предыдущей статье мы реализовали алгоритм Soft Actor-Critic, но не смогли обучить прибыльную модель. В данной статье мы проведем оптимизацию ранее созданной модели для получения желаемых результатов её работы.
Хотите найти новый подход в торговле, который поможет ориентироваться на сложных и постоянно меняющихся рынках? Взгляните на карты Кохонена — инновационную форму искусственных нейронных сетей, которая поможет выявить скрытые закономерности и тренды в рыночных данных. В этой статье мы рассмотрим, как работают карты Кохонена и как их использовать для разработки эффективных торговых стратегий. Думаю, этот новый подход будет интересен как опытным трейдерам, так и начинающим.
В рамках разработанного автором инженерного подхода, основанного на теории вероятности, находятся условия открытия прибыльной позиции и рассчитываются оптимальные – максимализирующие прибыль - значения тейкпрофита и стоплосса.
Мы продолжаем рассмотрение алгоритмов обучения с подкреплением в решении задач непрерывного пространства действий. И в данной статье предлагаю познакомиться с алгоритмом Soft Аctor-Critic (SAC). Основное преимущество SAC заключается в способности находить оптимальные политики, которые не только максимизируют ожидаемую награду, но и имеют максимальную энтропию (разнообразие) действий.
В предыдущей статье мы познакомились с методом DDPG, который позволяет обучать модели в непрерывном пространстве действий. Однако, как и другие методы Q-обучения, DDPG склонен к переоценки значений Q-функции. Эта проблема часто приводит к обучению агента с неоптимальной стратегией. В данной статье мы рассмотрим некоторые подходы преодоления упомянутой проблемы.
Статья продолжает серию о реализации теории категорий в MQL5. Здесь мы вводим моноиды как домен (множество), который отличает теорию категорий от других методов классификации данных за счет включения правил и элемента равнозначности.
В данной статье мы расширяем спектр задач нашего агента. В процесс обучения будут включены некоторые аспекты мани- и риск-менеджмента, которые являются неотъемлемой частью любой торговой стратегии.
Предлагаю Вам познакомиться с ещё одним направлением в области обучения с подкреплением. Оно называется обучением с подкреплением, направленное на достижение целей (Goal-conditioned reinforcement learning, GCRL). В этом подходе агент обучается достигать различных целей в определенных сценариях.
Что вы думаете: создавать системы для изучения рынка, когда он закрыт, или создать систему, которая позволит моделировать рыночные ситуации? Здесь мы начнем новую серию статей, посвященных этому вопросу.
Обучение полезных навыков без явной функции вознаграждения является одной из основных задач в иерархическом обучении с подкреплением. Ранее мы уже познакомились с 2 алгоритмами решения данной задачи. Но вопрос полноты исследования окружающей среды остается открытым. В данной статье демонстрируется иной подход к обучению навыком. Использование которых напрямую зависит от текущего состояния системы.
В предыдущей статье мы познакомились с методом DIAYN, который предлагает алгоритм изучения разнообразных навыков. Использование полученных навыкает может быть использовано различных задач. Но подобные навыки могут быть довольно непредсказуемы, что может осложнить из использование. В данной статье мы рассмотрим алгоритм обучения предсказуемых навыков.
В данной статье мы создадим математическую модель для симуляции мультивалютного ценообразования и завершим исследование принципа диверсификации в рамках поиска механизмов увеличения эффективности торговли, которое я начал в предыдущей статье с теоретических выкладок.
Чтобы завершить этот цикл статей об автоматизации, мы дополним то, что рассмотрели в предыдущей статье. Это определенно показывает, как всё будет сочетаться друг с другом, заставляя советника работать как часы.
Проблема обучения с подкреплением заключается в необходимости определения функции вознаграждения, которая может быть сложной или затруднительной для формализации, и для решения этой проблемы исследуются подходы, основанные на разнообразии действий и исследовании окружения, которые позволяют обучаться навыкам без явной функции вознаграждения.
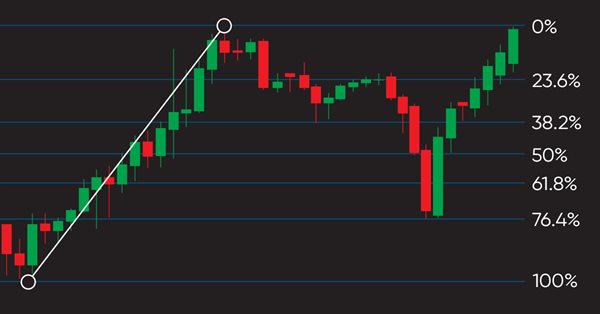
Это продолжение серии статей, в которых мы учимся строить торговые системы на основе самых популярных индикаторов. Очередным техническим инструментом станет индикатор Фибоначчи. Давайте разберем, как написать программу по сигналам этого индикатора.