A qualidade da previsão de estados futuros desempenha um papel importante no método Goal-Conditioned Predictive Coding, com o qual nos familiarizamos no artigo anterior. Neste artigo, quero apresentar a vocês um algoritmo capaz de aumentar significativamente a qualidade da previsão em ambientes estocásticos, que incluem os mercados financeiros.
Continuação da série para iniciantes. Aqui veremos como criar constantes e variáveis, registrar datas, cores e outros dados úteis. Aprenderemos a criar enumerações como dias da semana ou estilos de linha (contínua, tracejada etc.). Variáveis e expressões são a base da programação. Elas estão em 99% dos programas, portanto é fundamental entendê-las. Se você é novato em programação, este é um bom ponto de partida. Se o nível de conhecimento em programação é muito básico, conforme meu artigo anterior (link no início).
Nos trabalhos anteriores, conhecemos o método Decision Transformer e vários algoritmos derivados dele. Experimentamos com diferentes métodos de definição de objetivos. Durante os experimentos, trabalhamos com diferentes maneiras de definir objetivos, mas o estudo da trajetória já percorrida pelo modelo sempre ficou fora de nosso foco. Neste artigo, quero apresentar um método que preenche essa lacuna.
Neste artigo, propomos explorar um algoritmo que utiliza operadores de melhoria de política de forma fechada para otimizar as ações do Agente em um ambiente off-line.
No aprendizado off-line, utilizamos um conjunto de dados fixo, e isso não abrange toda a variedade do ambiente. Durante o processo de treinamento, nosso Agente pode gerar ações fora desse conjunto. Sem feedback do ambiente, a precisão dessas ações é duvidosa. Manter a política do Agente dentro do conjunto de treinamento se torna importante para confiar nos resultados. Vamos falar mais sobre isso aqui neste artigo.
Desde os primeiros artigos sobre aprendizado por reforço, a gente sempre falou de duas coisas: como explorar o ambiente e definir a função de recompensa. Os artigos mais recentes foram dedicados à exploração durante o aprendizado off-line. Neste aqui, quero apresentar a você um algoritmo em que os autores resolveram deixar de lado a função de recompensa.
Neste artigo, vamos explorar a aplicação de filtros digitais em séries temporais representadas no domínio da frequência, com o objetivo de extrair características únicas que podem ser úteis para modelos de previsão.
Criaremos um EA de hedge simples como base para nosso EA Grid-Hedge mais avançado, que será uma mistura de estratégias clássicas de grade e de hedge clássicas. Ao final deste artigo, você saberá como criar uma estratégia de hedge simples e o que as pessoas estão dizendo sobre a lucratividade dessa estratégia.
Aprenda sobre paradigmas de programação e suas aplicações no código MQL5. Neste artigo, exploramos as características da programação procedural, além de oferecer exemplos práticos. Você aprenderá como desenvolver um Expert Advisor baseado na dinâmica de preços (Price Action), utilizando o indicador EMA e dados de velas. Além disso, o artigo apresenta o paradigma da programação funcional.
Neste artigo, por EA multimoeda, entendemos um robô investidor, que pode negociar (abrir/fechar ordens, gerenciar ordens, por exemplo, do tipo trailing stop-loss e trailing profit) mais de um par de moedas em um gráfico. Neste artigo, utilizaremos sinais de dois indicadores, nomeadamente Bandas de Bollinger (Bollinger Bands®) e canal de Keltner.
Neste artigo, continuaremos a falar sobre métodos de coleta de dados em uma amostra de treinamento. É claro que o processo de aprendizado requer constante interação com o ambiente. Mas as situações podem variar.
O treinamento de modelos em modo off-line é realizado com dados de uma amostra de treinamento previamente preparada. Isso nos oferece várias vantagens, mas também comprime significativamente as informações sobre o ambiente em relação às dimensões da amostra de treinamento. Isso, por sua vez, limita as possibilidades de pesquisa. Neste artigo, quero apresentar um método que permite enriquecer a amostra de treinamento com dados o mais diversificados possível.
Neste artigo, convido você a conhecer um algoritmo interessante que se situa na interseção entre os métodos de aprendizado supervisionado e de reforço.
Neste artigo, por EA multimoeda, entendemos um robô investidor, ou um robô de negociação, que pode negociar (abrir/fechar ordens, gerenciar ordens, por exemplo, do tipo trailing stop-loss e trailing profit) mais de um par de moedas em um gráfico. Desta vez, usaremos apenas um indicador, em particular a média móvel triangular em um ou mais timeframes, ou escalas de tempo.
Este artigo é uma introdução a uma série completa de artigos sobre programação. Aqui supomos que o leitor nunca teve contato com programação antes. Por isso, começo pelo básico, com nível de conhecimento de programação: iniciante absoluto.
Pelo resultado dos testes realizados em artigos anteriores, concluímos que a qualidade da estratégia treinada depende muito da amostra de treinamento utilizada. Neste artigo, apresento a vocês um método simples e eficaz para selecionar trajetórias com o objetivo de treinar modelos.
Continuamos nossa análise, desta vez, explorando a família de transformadores de decisão. Em trabalhos anteriores, já observamos que o treinamento do transformador subjacente à arquitetura desses métodos é bastante desafiador e requer uma grande quantidade de dados de treinamento rotulados. Neste artigo, consideramos um algoritmo para usar trajetórias não rotuladas com o objetivo de pré-treinar modelos.
Recebi comentários de vários colegas traders sobre como usar o Expert Advisor multimoedas que estou analisando com corretoras que usam prefixos e/ou sufixos com nomes de símbolos, bem como sobre como implementar fusos horários de negociação ou sessões de negociação no Expert Advisor.
Nos últimos artigos, exploramos várias formas de usar o método Decision Transformer. Ele permite analisar não só o estado atual, mas também a trajetória de estados anteriores e as ações realizadas neles. Neste artigo, proponho que você conheça uma forma de usar este método em modelos hierárquicos.
Durante o aprendizado off-line, otimizamos a política do Agente com base nos dados da amostra de treinamento. A estratégia resultante confere ao Agente confiança em suas ações. Mas, essa confiança nem sempre é justificada, já que pode acarretar maiores riscos durante a utilização prática do modelo. Hoje vamos examinar um dos métodos para reduzir esses riscos.
Neste artigo, examinaremos os princípios para criar indicadores com vários símbolos/períodos e recuperar dados deles dentro de EAs e indicadores. Veremos as nuances mais importantes ao usar multi-indicadores em EAs e indicadores, e sua plotagem mediante buffers de indicador personalizado.
Desta vez, veremos exemplos de passagem de indicadores ao perceptron. Abordaremos conceitos gerais, um Expert Advisor simples pronto, os resultados de sua otimização e testes forward.
As últimas 2 partes foram dedicadas ao método transformador de decisões (DT), que modela sequências de ações no contexto de um modelo autorregressivo de recompensas desejadas. Neste artigo, vamos considerar outro algoritmo de otimização deste método.
No artigo anterior, nos familiarizamos com o transformador de decisões. Porém, o complexo ambiente estocástico do mercado de moedas não permitiu revelar totalmente o potencial do método apresentado. Hoje, quero apresentar a vocês um algoritmo focado em melhorar o desempenho dos algoritmos em ambientes estocásticos.
Neste artigo, apresentaremos a implementação de vários indicadores de rentabilidade e risco, considerados alternativas ao índice de Sharpe, e exploraremos curvas de patrimônio líquido hipotéticas para analisar suas características.
Continuamos a explorar os métodos de aprendizado por reforço. Neste artigo, proponho apresentar um algoritmo ligeiramente diferente que considera a política do agente sob a perspectiva de construir uma sequência de ações.
Neste artigo, por EA multimoeda, entendemos um robô investidor ou um robô de negociação que pode negociar (abrir/fechar ordens, gerenciar ordens como trailing-stop-loss e trailing profit) mais de um par de moedas em um gráfico. Desta vez, usaremos apenas um indicador, o Parabolic SAR ou iSAR, em vários timeframes, começando com PERIOD_M15 e terminando com PERIOD_D1.
Neste artigo de referência, vamos dar uma olhada nos indicadores padrão da categoria Indicadores de tendência. Criaremos modelos prontos a serem usados em Expert Advisors, modelos esses que incluirão: declaração e configuração de parâmetros, inicialização/desinicialização de indicadores e recuperação de dados/sinais a partir de buffers de indicador em EAs.
Neste artigo, examinaremos os indicadores padrão das categorias Volumes e Bill Williams. Criaremos modelos prontos a serem usados em Expert Advisors, modelos esses que incluirão: declaração e configuração de parâmetros, inicialização/desinicialização de indicadores e recuperação de dados/sinais a partir de buffers de indicador em EAs.
Apresentamos um algoritmo relativamente novo, o Stochastic Marginal Actor-Critic (SMAC), que permite a construção de políticas de variáveis latentes no contexto da maximização da entropia.
Ao criar um sistema de negociação, há sempre uma tarefa que deve ser resolvida com eficiência. Essa tarefa é a colocação de ordens ou seu processamento automático pelo sistema de negociação. Neste artigo, apresentamos a criação de um sistema de negociação do ponto de vista da colocação eficiente de ordens.
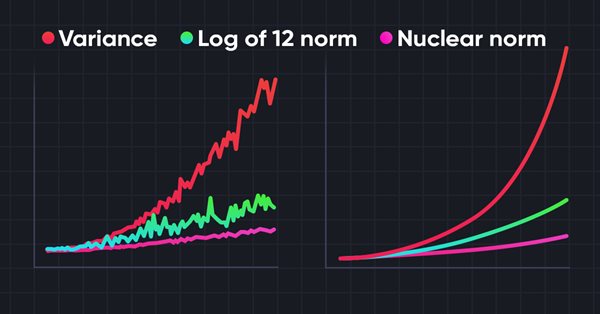
A pesquisa do ambiente em tarefas de aprendizado por reforço é um problema atual. Anteriormente, já examinamos algumas abordagens. E hoje, eu proponho que nos familiarizemos com mais um método, baseado na maximização da norma nuclear. Ele permite que os agentes destaquem estados do ambiente com alto grau de novidade e diversidade.
O aprendizado contrastivo é um método de aprendizado de representação sem supervisão. Seu objetivo é ensinar o modelo a identificar semelhanças e diferenças nos conjuntos de dados. Neste artigo, discutiremos o uso de abordagens de aprendizado contrastivo para explorar diferentes habilidades do Ator.
Neste artigo, mostrarei a primeira parte das melhorias que me permitiram não apenas fechar todo o ciclo de automação para negociação no MetaTrader 4 e 5, mas também fazer algo muito mais interessante. A partir de agora, esta solução me permite automatizar completamente tanto o processo de criação de EAs quanto o processo de otimização, além de minimizar o esforço necessário para encontrar configurações de negociação eficazes.
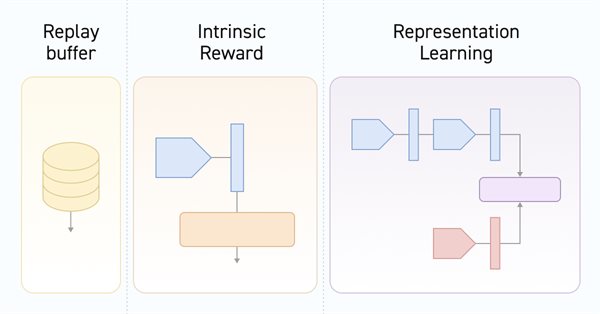
A cada vez que consideramos métodos de aprendizado por reforço, nos deparamos com a questão da exploração eficiente do ambiente. A solução deste problema frequentemente leva à complexificação do algoritmo e ao treinamento de modelos adicionais. Neste artigo, vamos considerar uma abordagem alternativa para resolver esse problema.
Neste artigo, vamos brevemente revisar a biblioteca de análise numérica ALGLIB 3.19, suas aplicações e novos algoritmos que aumentam a eficácia da análise de dados financeiros.
Neste artigo, por EA multimoeda, entendemos um Expert Advisor ou robô de negociação capaz de negociar (abrir/fechar ordens, gerenciar ordens, etc.) mais de um par de símbolos a partir de um único gráfico.