En este artículo, te explicaremos cómo desarrollar un factor de calidad que tu Asesor Experto (EA) pueda mostrar en el simulador de estrategias. Te presentaremos dos formas de cálculo muy conocidas (Van Tharp y Sunny Harris).
El artículo forma parte de una serie sobre la implementación de grafos utilizando la teoría de categorías en MQL5 y está dedicado a la relación de orden (Order Theory). Hoy analizaremos dos tipos básicos de orden y exploraremos cómo los conceptos de relación de orden pueden respaldar conjuntos monoides en las decisiones comerciales.
El presente artículo continúa la serie sobre la implementación de la teoría de categorías en MQL5. Aquí veremos cómo podemos integrar la teoría de grafos con los monoides y otras estructuras de datos al desarrollar una estrategia de cierre del sistema comercial.
En este artículo ampliamos el abanico de tareas de nuestro agente. El proceso de entrenamiento incluirá algunos aspectos de la gestión de capital y del riesgo que forma parte integral de cualquier estrategia comercial.
En el artículo de hoy, nos familiarizaremos con otra tendencia en el campo del aprendizaje por refuerzo. Se denomina aprendizaje por refuerzo dirigido a objetivos (Goal-conditioned reinforcement learning, GCRL). En este enfoque, el agente se entrenará para alcanzar diferentes objetivos en determinados escenarios.
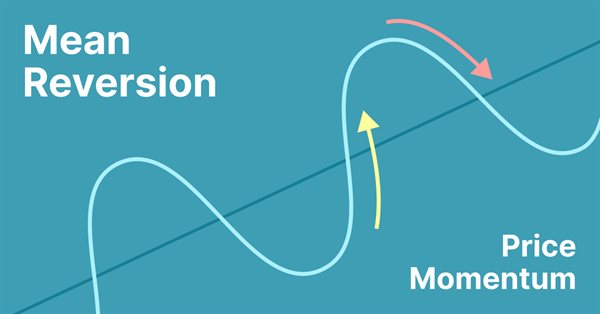
La reversión a la media es una técnica de negociación de contratendencia en la que el tráder espera que el precio regrese a algún tipo de equilibrio, que generalmente se mide usando una media u otro indicador estadístico de la tendencia promediada.
El entrenamiento de habilidades útiles sin una función de recompensa explícita es uno de los principales desafíos del aprendizaje por refuerzo jerárquico. Ya nos hemos familiarizado antes con dos algoritmos para resolver este problema, pero el tema de la exploración del entorno sigue abierto. En este artículo, veremos un enfoque distinto en el entrenamiento de habilidades, cuyo uso dependerá directamente del estado actual del sistema.
En el artículo anterior, nos familiarizamos con el método DIAYN, que ofrece un algoritmo para el aprendizaje de diversas habilidades. El uso de las habilidades aprendidas puede aprovecharse en diversas tareas, pero estas habilidades pueden resultar bastante impredecibles, lo cual puede dificultar su uso. En este artículo, analizaremos un algoritmo para el aprendizaje de habilidades predecibles.
El presente artículo continúa la serie sobre la implementación de la teoría de categorías en MQL5. Hoy analizaremos los grupos monoidales como un medio que normaliza conjuntos de monoides y los hace más comparables entre una gama más amplia de conjuntos de monoides y tipos de datos.
El problema del aprendizaje por refuerzo reside en la necesidad de definir una función de recompensa, que puede ser compleja o difícil de formalizar. Para resolver esto, se están estudiando enfoques basados en la variedad de acciones y la exploración del entorno que permiten aprender habilidades sin una función de recompensa explícita.
La procrastinación del modelo en el contexto del aprendizaje por refuerzo puede deberse a varias razones, y para solucionar este problema deberemos tomar las medidas pertinentes. El artículo analiza algunas de las posibles causas de la procrastinación del modelo y los métodos para superarlas.
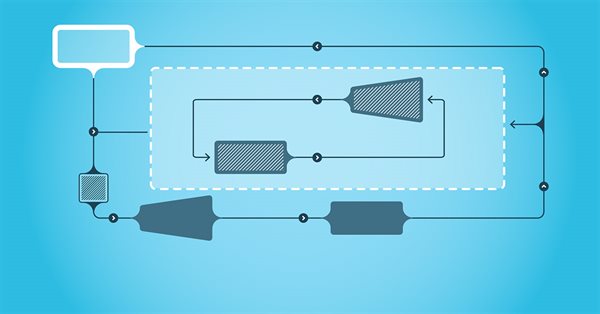
El presente artículo describe modelos de aprendizaje jerárquico que ofrecen un enfoque eficiente para resolver problemas complejos de aprendizaje automático. Los modelos jerárquicos constan de varios niveles; cada uno de ellos es responsable de diferentes aspectos del problema.
La transformada de Fourier, introducida por Joseph Fourier, es un medio para descomponer puntos de datos de ondas complejos en componentes de ondas simples. Esta característica puede resultar útil para los tráders, así que hablaremos de ella en este artículo.
Este artículo analizará el uso del algoritmo Go-Explore durante un largo periodo de aprendizaje, ya que la estrategia de elección aleatoria puede no conducir a una pasada rentable a medida que aumenta el tiempo de entrenamiento.
Continuamos con el tema de la exploración del entorno en los modelos de aprendizaje por refuerzo. En este artículo, analizaremos otro algoritmo: Go-Explore, que permite explorar eficazmente el entorno en la etapa de entrenamiento del modelo.
Uno de los principales retos del aprendizaje por refuerzo es la exploración del entorno. Con anterioridad, hemos aprendido un método de exploración basado en la curiosidad interior. Hoy queremos examinar otro algoritmo: la exploración mediante el desacuerdo.
Hoy utilizaremos un enfoque comercial de cuadrícula con órdenes stop pendientes en un asesor experto en el lenguaje de estrategias comerciales MQL5 para MetaTrader 5 en la Bolsa de Moscú (MOEX). Al comerciar en el mercado, una de las estrategias más simples consiste en colocar una cuadrícula de órdenes diseñada para "atrapar" el precio del mercado.
La teoría de categorías es un apartado diverso y en expansión de las matemáticas, que solo recientemente ha comenzado a ser trabajado por la comunidad MQL5. Esta serie de artículos tiene por objetivo repasar algunos de sus conceptos para crear una biblioteca abierta y seguir usando este maravilloso apartado en la creación de estrategias comerciales.
Ejemplo de utilización de un perceptrón como herramienta autónoma de predicción de precios. En el artículo exploraremos los conceptos generales y veremos un sencillo asesor experto ya preparado, así como los resultados de su optimización.
Las redes neuronales lo son todo. Vamos a comprobar en la práctica si esto es así. MetaTrader 5 como herramienta autosuficiente para el uso de redes neuronales en el trading. Una explicación sencilla.
La teoría de categorías es un apartado diverso y en expansión de las matemáticas, que solo recientemente ha comenzado a ser trabajado por la comunidad MQL5. Esta serie de artículos tiene por objetivo repasar algunos de sus conceptos para crear una biblioteca abierta y seguir usando este maravilloso apartado en la creación de estrategias comerciales.
En este artículo, veremos una plantilla simple para crear un robot MetaTrader universal que se pueda usar en varios gráficos, pero adjunto a uno solo, sin necesidad de configurar cada ejemplar del robot en cada gráfico individual.
En el artículo anterior, analizamos los modelos relacionales que utilizan mecanismos de atención en su arquitectura. Una de las características de dichos modelos es su mayor uso de recursos informáticos. Este artículo propondrá uno de los posibles mecanismos para reducir el número de operaciones computacionales dentro del bloque Self-Attention o de auto-atención, lo cual aumentará el rendimiento del modelo en su conjunto.
Las redes neuronales lo son todo. Vamos a comprobar en la práctica si esto es así. MetaTrader 5 como herramienta autosuficiente para el uso de redes neuronales en el trading. Una explicación sencilla.
En los modelos de aprendizaje por refuerzo analizados anteriormente, usamos varias opciones de redes convolucionales que pueden identificar varios objetos en los datos originales. La principal ventaja de las redes convolucionales es su capacidad de identificar objetos independientemente de la ubicación de estos. Al mismo tiempo, las redes convolucionales no siempre son capaces de hacer frente a diversas deformaciones de los objetos y al ruido. Pero estos problemas pueden resolverse usando el modelo relacional.
Aquí pondremos realmente en práctica todos los conocimientos de esta serie. Finalmente construiremos un sistema 100% automático y funcional. Pero para hacer esto, tendrás que aprender una última cosa.
El perceptrón multicapa es una evolución del perceptrón simple, capaz de resolver problemas separables no linealmente. Junto con el algoritmo de retropropagación, es posible entrenar eficientemente esta red neuronal. En la tercera parte de la serie sobre el perceptrón multicapa y la retropropagación, mostraremos cómo integrar esta técnica con el simulador de estrategias. Esta integración permitirá utilizar análisis de datos complejos y tomar mejores decisiones para optimizar las estrategias de negociación. En este resumen, analizaremos las ventajas y los retos de la aplicación de esta técnica.
¿Sabes lo que es un diagrama de flujo? ¿Sabes cómo utilizarlo? ¿Cree que los diagramas de flujo son sólo cosas de aprendiz de programador? Pues echa un vistazo a este artículo y aprende a trabajar con diagramas de flujo.
Si crees que los sistemas automatizados son sencillos, eso indica que aún no has entendido del todo lo necesario para crearlos. En este texto, hablaremos de un problema al que se enfrentan muchos Expert Advisors: la ejecución indiscriminada de órdenes, y de una posible solución a este problema.
Las redes neuronales lo son todo. Vamos a comprobar en la práctica si esto es así. MetaTrader 5 como herramienta autosuficiente para el uso de redes neuronales en el trading. Una explicación sencilla.
Un sistema automatizado sin seguridad no tendrá éxito. Sin embargo, la seguridad no se consigue sin entender bien algunas cosas. En este artículo, comprenderemos por qué es tan difícil lograr la máxima seguridad en los sistemas automatizados.
La automatización no significa nada si no se puede controlar el horario. Ningún trabajador puede ser eficiente trabajando 24 horas al día. Sin embargo, muchos creen que un sistema automatizado debe trabajar 24 horas al día. Siempre es bueno tener formas de configurar una franja horaria para el Expert Advisor. En este artículo, vamos a discutir cómo agregar correctamente tal franja horaria.
Aunque la creación de un Expert Advisor automático no es una tarea muy complicada, sin los conocimientos adecuados, se puede acabar cometiendo muchos errores. En este artículo, vamos a ver cómo construir el primer nivel de automatización, que es crear el disparador para activar breakeven y trailing stop.
Seguimos analizando los algoritmos de aprendizaje por refuerzo. Todos los algoritmos que hemos estudiado hasta ahora requerían la creación de una política de recompensas tal que el agente pudiera evaluar cada una de sus acciones en cada transición de un estado del sistema a otro, pero este enfoque resulta bastante artificial. En la práctica, existe cierto tiempo de retraso entre la acción y la recompensa. En este artículo, le sugerimos que se familiarice con un algoritmo de entrenamiento de modelos que puede funcionar con varios retrasos de tiempo desde la acción hasta la recompensa.
Seguimos analizando algoritmos de aprendizaje Q distribuidos. En artículos anteriores hemos analizado los algoritmos de aprendizaje Q distribuido y cuantílico. En el primero, enseñamos las probabilidades de los rangos de valores dados. En el segundo, enseñamos los rangos con una probabilidad determinada. Tanto en el primer algoritmo como en el segundo, usamos el conocimiento a priori de una distribución y enseñamos la otra. En el presente artículo, veremos un algoritmo que permite al modelo aprender ambas distribuciones.
En este artículo, intentaremos analizar algunas formas de construir indicadores no lineales, así como su uso en el trading. Existen bastantes indicadores en la plataforma comercial MetaTrader que utilizan enfoques no lineales.
Continuamos explorando el aprendizaje Q distribuido. Hoy analizaremos este enfoque desde un ángulo diferente. Vamos a hablar de la posibilidad de utilizar la regresión cuantílica para resolver el problema de la previsión de los movimientos de precio.