В данной статье предлагаем познакомиться с методом Mask-Attention-Free Transformer (MAFT) и его применение в области трейдинга. В отличие от традиционных Transformer, требующих маскирования данных при обработке последовательностей, MAFT оптимизирует процесс внимания, устраняя необходимость в маскировании, что значительно повышает вычислительную эффективность.
Статья посвящена метаэвристическому алгоритму Atmosphere Clouds Model Optimization (ACMO), который моделирует поведение облаков для решения задач оптимизации. Алгоритм использует принципы генерации, движения и распространения облаков, адаптируясь к "погодным условиям" в пространстве решений. Статья раскрывает, как метеорологическая симуляция алгоритма находит оптимальные решения в сложном пространстве возможностей и подробно описывает этапы работы ACMO, включая подготовку "неба", рождение облаков, их перемещение и концентрацию дождя.
Наконец, наш индикатор Chart Trade начинает взаимодействовать с советником, позволяя передавать информацию в интерактивном режиме. Поэтому в этой статье мы доработаем индикатор, сделав его функциональным настолько, чтобы его можно было использовать вместе с каким-либо советником. Это позволит нам получить доступ к индикатору Chart Trade и работать с ним, как если бы он действительно был связан с советником. Но сделаем мы это гораздо более интересным способом чем ранее.
В данной статья предлагаем познакомиться с методом сегментации 3D-люъектов на основе Superpoint Transformer (SPFormer), который устраняет необходимость в промежуточной агрегации данных. Что ускоряет процесс сегментации и повышает производительность модели.
Мы рассмотрим статистический арбитраж, выполним поиск символов корреляции и коинтеграции с помощью Python, создадим индикатор для коэффициента Пирсона, а также советник для торговли статистическим арбитражем с прогнозами, сделанными с помощью Python и моделей ONNX.
Пошаговое руководство по созданию и реализации автоматизированного торгового алгоритма на основе разрывов справедливой стоимости (Fair Value Gap, FVG) на языке MQL5. Подробное руководство может быть полезно как новичкам, так и опытным трейдерам.
В статье рассматривается использование встроенных индикаторов MetaTrader 5 для отсеивания нетрендовых сигналов. Продолжая предыдущую статью, мы рассмотрим, как это сделать с помощью кода MQL5, чтобы воплотить нашу идею в виде программы.
В этой статье рассказывается о том, как писать пользовательские индикаторы на языке MQL5. Это вводная часть, в которой вы познакомитесь с основами создания простых пользовательских индикаторов. В ней продемонстрирован практический подход к программированию различных пользовательских индикаторов. Материал предназначен для тех, кто еще в начал пути по изучению программирования на MQL5.
Эффективное выявление и сохранение локальной структуры рыночных данных в условиях шума является важной задачей в трейдинге. Использование механизма Self-Attention показало хорошие результаты в обработке подобных данных, но классический метод не учитывают локальные особенности исходной структуры. В данной статье я предлагаю познакомиться с алгоритмом, способным учитывать эти структурные зависимости.
Предлагаем вам познакомиться с новым подход обнаружения объектов при помощи гиперсетей. Гиперсети могут генерировать весовые коэффициенты для основной модели, что позволяет учитывать особенности текущего состояния рынка. Такой подход позволяет улучшить точность прогнозирования, адаптируя модель к различным торговым условиям.
В данной статье подробно рассматривается алгоритм оптимизации, вдохновленный стрельбой из лука, с акцентом на использование метода рулетки в качестве механизма выбора перспективных областей для "стрел". Этот метод позволяет оценивать качество решений и отбирать наиболее многообещающие позиции для дальнейшего изучения.
В данной статье мы поговорим об алгоритмах использования методов внимания при решении задач обнаружения объектов в облаке точек. Обнаружение объектов в облаках точек имеет важное значение для многих реальных приложений.
В этой статье мы поговорим об индикаторе волатильности Чайкина (Chaikin Volatility, CHV). Разберемся, что делает этот индикатор, как и в каких условиях его можно использовать и как создать пользовательский индикатор волатильности. Проанализируем несколько простых стратегий и протестируем их, чтобы понять, какая стратегия лучше.
Устали тратить время на поиск того самого файла, который необходим для работы вашего приложения? Как насчет того, чтобы включить все в исполняемый файл? Так вы больше не будете тратить время на поиск необходимого. Знаю, что многие пользуются именно такой формой распространения и хранения вещей, но есть гораздо более подходящий способ. По крайней мере, что касается распространения исполняемых файлов и их хранения. Метод, который будет здесь представлен, может оказаться очень полезным, так как в качестве отличного помощника вы сможете использовать сам MetaTrader 5, а также MQL5. И это не так уж трудно и сложно для понимания.
Продолжаем изучение алгоритмов для извлечения признаков из облака точек. И в данной статье мы познакомимся с механизмами повышения эффективности метода PointNet.
Статья рассчитана на начинающих и профессиональных разработчиков MQL5. Она предоставляет фрагмент кода для определения индикаторов, генерирующих сигналы, и их ограничения трендами на более старших таймфреймах. Таким образом, трейдеры могут улучшить свои стратегии, включив в них более широкую перспективу рынка, что приведет к получению потенциально более надежных торговых сигналов.
ONNX — отличный инструмент для интеграции сложного ИИ-кода на разных платформах. Однако при его использовании возникают некоторые сложности, которые необходимо преодолеть, чтобы извлечь из него максимальную пользу. В этой статье мы обсудим распространенные проблемы, с которыми вы можете столкнуться, и способы их устранения.
Прямой анализ облака точек позволяет избежать излишнего увеличения объема данных и повышает эффективность моделей в задачах классификации и сегментации. Подобные подходы демонстрируют высокую производительность и устойчивость к возмущениям в исходных данных.
Продолжаем изучение метода Иерархического Векторного Transformer. И в данной статье мы завершим построение модели. А также проведем её обучение и тестирование на реальных исторических данных.
Главное в этой статье — представление и объяснение класса C_ChartFloatingRAD. У нас есть индикатор Chart Trade, который работает довольно интересным образом. Как вы могли заметить, у нас на графике все еще достаточно небольшое количество объектов, и тем не менее, мы получили ожидаемое функционирование. Значения, присутствующие в индикаторе, можно редактировать. Вопрос в том, как это возможно? В этой статье все начнет проясняться.
Предлагаем познакомиться с методом Иерархический Векторный Transformer (HiVT), который был разработан для быстрого и точного прогнозирования мультимодальных временных рядов.
Сейчас наш советник использует базу данных для получения строк инициализации одиночных экземпляров торговых стратегий. Однако база данных является достаточно объёмной и содержит много информации, ненужной при реальной работе советника. Попробуем обеспечить работоспособность советника без обязательного подключения к базе данных.
Метод опорных векторов (Support Vector Machines) классифицирует данные на основе предопределенных классов, исследуя эффекты увеличения их размерности. Это метод обучения с учителем, который довольно сложен, учитывая его потенциальную возможность работы с многомерными данными. В этой статье мы рассмотрим, как эффективнее реализовать базовую версию двумерных данных с помощью полинома Ньютона при классификации ценовых действий.
Понимание поведения агентов важно в разных областях, но большинство методов фокусируются на одной задаче (понимание, удаление шума, прогнозирование), что снижает их эффективность в реальных сценариях. В данной статье я предлагаю познакомиться с моделью, которая способна адаптироваться к решению различных задач.
Пробуем создать индикатор на основе квадрата 9 Ганна, построенного по квадрированию времени и цены. Напишем код и протестируем индикатор в платформе на разных временных промежутках.
В данной статье я хочу познакомить вас с одним интересным методом прогнозирования траекторий, разработанным для решения задач в области автономного движения транспортных средств. Авторы метода объединили в нем лучшие элементы различных архитектурных решений.
В предыдущей статье я объяснил, как можно управлять данными шаблона для их использования в OBJ_CHART. Там я лишь обозначил тему, не вдаваясь в подробности, поскольку в той версии работа была выполнена очень упрощенным способом. Это сделано для того, чтобы облегчить объяснение содержания, ведь несмотря на кажущуюся простоту многих вещей, некоторые из них не столь очевидны, а без понимания самой простой и основной части, вы не сможете по-настоящему разобраться в том, что мы делаем.
В основе большого количества рассмотренных нами ранее моделей лежит архитектура Transformer. Однако они могут быть неэффективны при работе с длинными последовательностями. И в этой статье я предлагаю познакомиться с альтернативным направлением прогнозирования временных рядов на основе моделей пространства состояний.
Большинство современных методов прогнозирования мультимодальных временных рядов используют подход независимых каналов. Тем самым игнорируется природная зависимость различных каналов одного временного ряда. Разумное использование 2 подходов (независимых и смешанных каналов) является ключом к повышению эффективности моделей.
Большинство людей, которые хотят или мечтают научиться программировать, на самом деле не имеют представления о том, что делают. Их деятельность заключается в попытках создавать вещи определенным образом. Однако программирование – это вовсе не подгонка под ответ подходящих решений. Если действовать таким образом, можно создать больше проблем, чем решений. Здесь мы будем делать нечто более продвинутое и, следовательно, другое.
Пространственно-временное слияние (Spatial Temporal Fusion, STF), которое использует как "пространственные", так и временные метрики при моделировании данных, в первую очередь применяется в дистанционном обследовании и во многих других областях, связанных с визуализацией, для лучшего понимания нашего окружения. Основываясь на опубликованной статье, мы изучим потенциал этого подхода для трейдеров.
Разрабатываемый советник должен показывать хорошие результаты при торговле у разных брокеров. Но мы пока что для тестов использовали котировки с демо-счёта от MetaQuotes. Посмотрим, готов ли наш советник к работе на торговом счёте с другими котировками по сравнению с теми, которые использовались при тестировании и оптимизации.
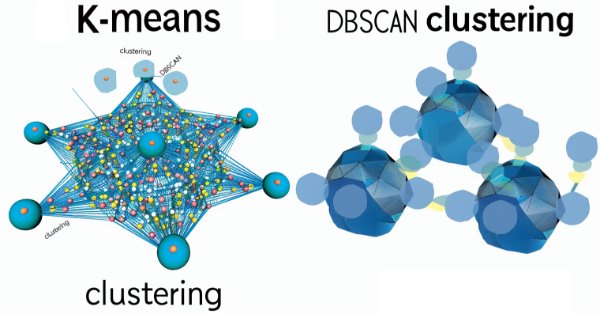
Основанная на плотности пространственная кластеризация для приложений с шумами (Density Based Spatial Clustering for Applications with Noise, DBSCAN) - это неконтролируемая форма группировки данных, которая практически не требует каких-либо входных параметров, за исключением всего двух, что по сравнению с другими подходами, такими как k-средние, является преимуществом. Разберемся в том, как это может быть полезно в тестировании и торговле с применением советников, собранных в Мастере.
Мы продолжаем рассмотрения моделей прогнозирования временных рядов. И в данной статье я предлагаю познакомиться с комплексным алгоритмом, построенным на использовании предварительно обученной языковой модели.
Легковесные модели прогнозирования временных рядов обеспечивают высокую производительность, используя минимальное количество параметров. Что, в свою очередь, снижает расход вычислительных ресурсов и ускоряет принятие решений. При этом они достигают качества прогнозов, сопоставимого с более сложными моделями.
Под мультивалютным советником в этой статье понимается советник, или торговый робот, который использует индикаторы ZigZag и Awesome Oscillator, фильтрующие сигналы друг друга.
Переменные и типы данных — очень важные темы не только в программировании на MQL5, но и в любом языке программирования. Переменные и типы данных MQL5 можно разделить на простые и расширенные. Здесь мы рассмотрим расширенные переменные и типы данных. Простые мы изучали в предыдущей статье.