В статье подробно рассматриваются теоретические основы и практическая реализация скрытой марковской модели с категориальными эмиссиями (Categorical HMM) на языке MQL5. На конкретных примерах демонстрируются процессы инференса, итерационного обучения параметров, онлайн-фильтрации, а также методология выбора оптимальной архитектуры модели по информационным критериям AIC/BIC.
Разбирается практическое применение L1 Trend Filter для очистки шума и формирования структурных признаков, совместимых с live-торговлей. Показан полный цикл: H1-данные 29 инструментов из MetaTrader 5, каузальная фильтрация, CatBoost на горизонте трёх L1-баров, честный walk-forward и распределение лотов по VaR. Читатель получает воспроизводимый кодовый конвейер и методику портфельной оценки.
Индикатор показателя Хёрста для MQL5 реализован на основе R/S-анализа с OLS-регрессией в log-log пространстве. Теоретическая опора — результаты Gatheral–Jaisson–Rosenbaum (2014), согласно которым волатильность — дробное броуновское движение с H ≈ 0.10. Индикатор оценивает H в скользящем окне, выделяет антиперсистентный (H < 0.3), нейтральный и трендовый (H > 0.5) режимы, окрашивает линию и подаёт алерт при смене режима, помогая выбирать тип стратегии и управлять риском.
Прогнозирование временных рядов в трейдинге прошло путь от традиционных статистических моделей, таких как ARIMA, к подходам глубокого обучения, но оба варианта требуют сложной настройки и обучения. Вдохновленная достижениями NLP, модель Google TimesFM предлагает фундаментальную предобученную модель для временных рядов, способную давать сильные прогнозы даже без обучения под конкретную задачу. Для трейдеров это особенно ценно: модель можно эффективно дообучать на собственных данных с помощью легких методов вроде LoRA, снижая переобучение и одновременно адаптируясь к меняющимся рыночным условиям.
В статье продолжена адаптация фреймворка UncAD для задач алгоритмического трейдинга. Реализованы объект распределения рыночных состояний и энкодер неопределённости, формирующий совместное представление состояния рынка и степени доверия к нему. Предложенная архитектура позволяет модели учитывать не только структуру рыночного режима, но и устойчивость собственной интерпретации, что особенно важно в условиях нестационарности финансовых рынков.
Мы создаем набор инструментов промышленного уровня для расчета размера позиции в MQL5: утилиты, фрагменты кода и пользовательские функции, которые повторяют исходные реализации на Python. Методы охватывают преобразование вероятности в размер позиции с коррекцией перекрытия, динамический расчет размера позиции по прогнозной цене (калиброванные сигмоидальная и степенная функции с лимитной ценой), бюджетирование на основе текущей занятости портфеля и резервный метод расчета размера позиции на основе модели смеси (EF3M). Результат — размер позиции со знаком в диапазоне [−1, ..., 1] плюс диагностика, которую можно напрямую подключить к логике ордеров.
Целочисленное дифференцирование заставляет выбирать между стационарностью и памятью: доходности (d = 1) стационарны, но отбрасывают всю информацию об уровне цены; исходные цены (d = 0) сохраняют память, но нарушают предпосылку стационарности, важную для моделей машинного обучения. В статье реализован метод дробного дифференцирования с окном фиксированной ширины (FFD) из главы 5 AFML: get_weights_ffd — итеративная рекурсия с отсечением по порогу, frac_diff_ffd — ограниченное скалярное произведение для каждого бара, fracdiff_optimal — бинарный поиск минимального стационарного d*.
Эта статья знакомит читателя с переосмысленной версией классической стратегии пробоев полос Боллинджера. В ней определены ключевые недостатки первоначального подхода, такие как его хорошо известная подверженность ложным пробоям. Цель статьи - представить возможное решение: торговую стратегию двойных полос Боллинджера (Double Bollinger Band). Этот относительно малоизвестный подход устраняет слабые места классической версии и предлагает более динамичный взгляд на финансовые рынки. Он помогает преодолеть старые ограничения, определенные первоначальными правилами, предлагая трейдерам более устойчивую и адаптивную систему.
Классификаторы на основе деревьев обычно избыточно уверены: истинные доли выигрышей около 0,55 отображаются как 0,65–0,80 и завышают размеры позиций и доли Келли. В этой статье представлены afml.calibration и CalibratorCV, которые генерируют OOF-прогнозы (out-of-fold, прогнозы для наблюдений вне обучающей части своего фолда) через PurgedKFold и обучают изотоническую регрессию или масштабирование Платта. Мы определяем оценку Брайера, ECE и MCE, а также показываем диагностику, которая прослеживает некалиброванность до размеров позиций, реализованного прибыли и убытка (P&L, profit and loss) и распределений коэффициента Шарпа по путям CPCV, что помогает обосновать торговлю без утечек и с корректно рассчитанным размером позиции.
Сигнал размера позиции из Части 10 скорректирован с учётом перекрытия активных меток, но не учитывает соотношение выигрыша и проигрыша, не реагирует на жёсткий бюджет просадки и не валидируется по комбинаторным путям. В этой статье рассматриваются три дополнения: двухэтапная архитектура, в которой множитель выплат Келли применяется поверх get_signal, сохраняя коррекцию перекрытия активных меток и добавляя асимметрию выигрыша/проигрыша; слой интеграции с проп-фирмой, который непрерывно калибрует параметр сигмоиды w по оставшемуся бюджету просадки в правилах FundedNext Stellar 2-Step; и фреймворк CPCV-бэктестирования, который моделирует заново инициализированное состояние счёта по всем путям φ[N, k], формируя распределение коэффициента Шарпа и выполняя аудит PBO.
Статья предлагает перенос принципов риск-ориентированного фреймворка UncAD в алгоритмический трейдинг и обосновывает сходство задач навигации и управления капиталом при неполной информации. Мы строим на MQL5/OpenCL карту плотности рыночных состояний, которая компактно кодирует историческую структуру. Это позволяет выявлять зоны поддержки/сопротивления и области низкой плотности для более устойчивого выбора действий.
Фиксированные доли и сырые вероятности неверно распределяют риск при перекрывающихся метках и провоцируют чрезмерную торговлю. В статье представлены четыре метода определения размера позиции, совместимые с AFML: вероятностный (z-score → CDF, усреднение активных сигналов, дискретизация), на основе прогнозной цены (sigmoid/power с калибровкой w и лимитной ценой), бюджетно-ограниченный (только направление) и резервный (mixture-CDF через EF3M). На выходе получается знаковый, ограниченный ряд позиций с описанными условиями применения.
В этой статье бэкенд оптимизации гиперпараметров Optuna (HPO) интегрируется в единый ModelDevelopmentPipeline. Добавлены совместная настройка гиперпараметров модели и схем весов выборки, раннее отсечение с Hyperband и отказоустойчивое SQLite-хранилище исследований. Пайплайн автоматически определяет первичные и вторичные модели, добавляет перед моделью обученный препроцессор удаления столбцов, обеспечивающий безопасный инференс, поддерживает последовательный бутстрэппинг, формирует отчет Optuna и интегрируется с bid/ask-пайплайном и LearnedStrategy. Читатели получают более быстрые, возобновляемые запуски и развертываемые самодостаточные модели.
GridSearchCV и RandomizedSearchCV имеют фундаментальное ограничение в финансовом ML: каждое испытание независимо, поэтому качество поиска не улучшается с ростом вычислительного бюджета. В этой статье Optuna — с использованием Tree-structured Parzen Estimator — интегрируется с кросс-валидацией PurgedKFold, ранней остановкой HyperbandPruner и соглашением о двух типах весов, которое разделяет веса обучения и веса оценки. В результате получается система из пяти компонентов: целевая функция с отсечением на уровне фолдов, слой преобразования/подстановки параметров, совместно оптимизирующий схему взвешивания и гиперпараметры модели, финансово откалиброванное отсечение, возобновляемый оркестратор на базе SQLite и конвертер в формат scikit-learn cv_results_. В статье также проводится четкое разграничение — на основе Тимоти Мастерса — между статистическими целями, где направленный поиск полезен, и финансовыми целями, где он вреден.
В статье рассматривается алгоритм оптимизации Архимеда — метаэвристика, в которой агент представлен физическим объектом с плотностью, объёмом и ускорением, а сам поиск переосмыслен как стремление погружённых в жидкость тел к равновесию. Баланс между разведкой и эксплуатацией здесь не задаётся внешним расписанием, а вытекает из физики затихающей турбулентности. Реализуем алгоритм на MQL5, прогоняем на стандартном стенде и разбираем, где такая идея работает.
В статье завершается адаптация фреймворка GDformer для прикладных задач трейдинга. Реализована архитектура анализа рыночного состояния, объединяющая механизмы глобального сопоставления паттернов GDformer и контекстный анализ ReGEN-TAD. Рассмотрены организация вычислительных магистралей, распределение градиентов в многопоточной модели и интеграция компонентов в единую систему. Практическое тестирование на данных EURUSD показало устойчивую работу модели, положительную доходность и способность учитывать контекст формирования рыночных сигналов.
В статье реализован Andean Condor Algorithm (ACA) для MQL5 — компактный оптимизатор с многомасштабным оператором интенсификации. Выявлен эффект значимого роста качества при малой популяции: одна корректировка настроек выводит его в топ-45 — и за этим стоит характерная особенность алгоритма, о которой стоит знать. Материал даёт готовый код и практические ориентиры по применению.
Статья продолжает серию об AI Hedge Fund и снимает три ограничения v4: репутации аналитиков теперь персистентны в SQLite, EA выведен из критического пути исполнения, а сигналы совета пятнадцати рассылаются на несколько брокеров через TradeMux REST API. Логика совета и риск-менеджмента не менялась: Python получает данные через MetaTrader 5 SDK и исполняет ордера напрямую. Результат — устойчивость к перезапускам и масштабирование на несколько терминалов.
Представлена реализация основного модуля GDformer — Global Dictionary-based Cross-Attention — для анализа финансовых временных рядов в среде MQL5/OpenCL. Описаны глобальный словарь паттернов, многоголовое кросс-внимание, ветка сходства с обучаемыми прототипами и разреженный SoftMax без повторной нормализации. Показано, как получать устойчивое контекстное представление рыночного состояния для последующего использования в торговой инфраструктуре.
В этой статье мы представляем библиотеку MQL5 для моделирования волатильности, разработанную так, чтобы функционировать аналогично пакету arch в Python. В настоящее время библиотека поддерживает спецификацию распространённых моделей условного среднего: HAR, AR, Constant Mean и Zero Mean, а также моделей условной волатильности: Constant Variance, ARCH и GARCH.
Показано, как организовать согласованный ML-конвейер в MetaTrader 5 с разделением ролей: Python обучает и экспортирует модель в ONNX, MQL5 воспроизводит нормализацию и PCA через matrix/vector и выполняет инференс. Такой подход делает входы модели стабильными и проверяемыми, а тестер стратегий MetaTrader 5 даёт метрики для анализа поведения системы.
Статья разбирает архитектуру GDformer применительно к алгоритмическому трейдингу. Показано, как обучаемая память, Dictionary-based Cross-Attention и Similarity Branch помогают сопоставлять текущее состояние рынка с выученными режимами и оценивать степень надёжности интерпретации. Дана реализация прямого прохода механизма внимания в OpenCL с использование разреженных коэффициентов без повторного перенормирования, что повышает устойчивость модели и эффективность на длинных последовательностях.
В статье разобрана архитектура советника на клеточном автомате с 10 000 адаптирующихся параметров и независимым бинарным предиктором на горизонте 10 баров. Показано трёхуровневое онлайн-обучение, эволюция стратегий и валидация через кольцевой буфер и матрицу ошибок. Параметры входа сведены к Magic Number, торговые настройки вычисляются из ATR и пяти геномов. Тест EURUSD H1 дал ориентировочный Hit Rate около 58% против ~51% у фиксированной MLP.
Узнайте, как исправить критический изъян в финансовом машинном обучении, который приводит к переобученным моделям и плохой работе в реальной торговле, — одновременность меток. При использовании метода тройного барьера (triple-barrier) обучающие метки перекрываются во времени, нарушая базовое предположение IID большинства ML-алгоритмов (алгоритмов машинного обучения). В статье показано практическое решение через взвешивание наблюдений: как измерять временное перекрытие торговых сигналов, рассчитывать взвешивание наблюдений с учётом уникальной информации и применять эти веса в scikit-learn для построения более устойчивых классификаторов. Освоение этих техник поможет сделать торговые модели более устойчивыми, надёжными и прибыльными.
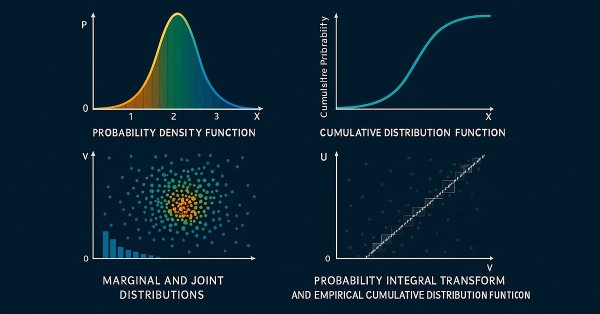
Это первая часть серии статей, посвящённых реализации двумерных копул в MQL5. В статье представлен код, реализующий гауссову копулу и t-копулу Стьюдента. Также рассматриваются основы статистических копул и связанные с ними темы. Код основан на Python-пакете ArbitrageLab от Hudson and Thames.
Разбираем алгоритм цветовой гармонии (CHA) — метаэвристику оптимизации, опирающуюся на теорию цветовой гармонии Манселла. Показываем устройство круга тонов, шаблоны гармонии, чередование фаз концентрации и рассеивания, а также роль памяти решений. От теоретического каркаса до рабочей реализации на MQL5 и честного тестирования на стандартном бенчмарке.
Статья описывает двухуровневый индикатор MarkovMLPOscillator: трехсостоянная марковская цепь на истории строит матрицу переходов и формирует 15 вероятностных признаков для каждого бара, а MLP обучается на них и прогнозирует направление через заданный горизонт. Рассмотрены генерация признаков, схема валидации на отложенной выборке и настройки параметров. Результат — интерпретируемый осциллятор с цветовой гистограммой, сглаженным сигналом и отображением текущей матрицы переходов.
В статье представлена инженерная реализация ReGEN-TAD для онлайн-обработки: единый вычислительный конвейер с магистралью (backbone) и универсальной генеративной головой прогнозирования/уточнения/реконструкции. Разобрана организация прямого и обратного прохода с запаздывающей обратной связью и контроль согласованности представлений. Тестирование в потоковом режиме иллюстрирует поведение системы и ограничения по риску; читатель получает готовую схему интеграции в торговый конвейер.
В последней части этой серии мы выходим за рамки отдельных методов машинного обучения и переходим к проблеме “исследовательского хаоса”, с которым сталкиваются многие количественные трейдеры. Эта статья посвящена переходу от разрозненных экспериментов в Jupyter Notebook к продуманному пайплайну промышленного уровня, обеспечивающему воспроизводимость, отслеживаемость и эффективность.
В статье реализована адаптация ReGEN-TAD под MQL5: риск трактуется как согласованность двух путей анализа — трансформера (контекст) и рекуррентной сети (динамика). Введён модуль токенизации разности, который формирует токен риска в общем пространстве признаков и передаёт его в последующие решения. Практический итог — готовые блоки для интеграции оценки уверенности в советники и для последующего обучения и тестирования.
В статье рассматриваются основы байесовской статистики в дискретном и непрерывном случаях. Мы пройдём путь от классической теоремы Байеса и простых примеров с подбрасыванием монеты до сопряжённых распределений и динамического байесовского обновления, позволяющего проводить анализ котировок в режиме реального времени. На примере бета-биномиальной модели реализован простой индикатор разладки (change point detection), помогающий определять смену рыночного режима.
Представляем эволюционный алгоритм без оператора селекции: лучшая особь становится единственным партнёром по скрещиванию для всей популяции, а классическая мутация заменена мультипликативной с самонастраивающимся шагом. В статье разбираем три ключевые идеи, реализуем алгоритм на MQL5 во фреймворке C_AO и проверяем его на стандартном стенде и античитер-тесте — где BOA вплотную приближается к порогу топ-45, но не входит в рейтинг.
Описана архитектура, в которой MQL5-советник выполняет только сбор данных и исполнение, а логика вынесена в Python-сервер с тремя агентами LangChain: сигнальным, новостным и риск-менеджером. Агенты последовательно обрабатывают запрос по WebSocket, при отказе любого возвращается hold. Решения и фактический PnL сохраняются в SQLite, формируя память и статистику. Читатель получит схему взаимодействия, протокол команд и подход к обратной связи.
Статья раскрывает фреймворк ReGEN-TAD для оценки рыночного риска через несогласованность представлений, объединяющий генеративную проверку (реконструкция и прогноз) и ансамблевый Anomaly Score с факторной интерпретацией. Показана логика согласования параллельных представлений и их расхождений. На практике реализован первый шаг в MQL5 — свёрточный токенизатор, формирующий компактный эмбеддинг окна рынка для последующей диагностики режимов.
Метапромптинг — подход, при котором LLM сама оптимизирует торговые инструкции на основе реального P&L и метрик качества сигналов. В статье показана практическая реализация на Python и MQL5: реестр версий промптов, исполнительный агент, оценщик по directional accuracy и profit factor и мета-LLM, которая в цикле генерирует улучшения. Решение встраивается в советник без остановки торговли.
В этой части основное внимание уделяется созданию гибкой, адаптивной торговой модели, обученной на исторических данных XAUUSD. Мы подготовим ее к экспорту в ONNX и потенциальной интеграции в системы реальной торговли.
Раскройте потенциал терминала MetaTrader 5 по максимуму с помощью Python-экосистемы анализа данных и официальной клиентской библиотеки MetaTrader 5. В этой статье показано, как пройти аутентификацию и напрямую передавать тики и минутные бары в хранилище Parquet, применять продвинутые методы создания признаков с помощью ta и Prophet, а также обучать модель градиентного бустинга с учетом временной структуры данных. Затем мы разворачиваем легковесный сервис Flask, который выдает торговые сигналы в реальном времени. Независимо от того, строите ли вы гибридную количественную торговую систему или усиливаете советник машинным обучением, в результате у вас будет надежный сквозной пайплайн для алгоритмической торговли на основе данных.
Устали смотреть на индикаторы выполнения вместо того, чтобы тестировать торговые стратегии? Традиционное кэширование не подходит для финансового машинного обучения, что приводит к потере результатов вычислений и вынуждает вас к повторному запуску, что вызывает раздражение. Мы разработали сложную архитектуру кэширования, учитывающую специфику финансовых данных — временные зависимости, сложные структуры данных и постоянную угрозу смещения look-ahead. Наша трёхслойная система обеспечивает значительное повышение скорости, автоматически отбрасывая устаревшие результаты и предотвращая утечку ценных данных. Хватит ждать результатов расчетов — начинайте действовать в темпе, которого требуют рынки.
BUZOA — популяционный метаэвристический алгоритм, в котором каждый агент на каждой итерации случайно выбирает одну из трёх тактик охоты: узкий поиск вокруг личного рекорда, классический PSO-шаг к лидеру стаи или полную телепортацию в случайную точку пространства. В статье разбирается реализация алгоритма на MQL5, показывается найденная в оригинальной формулировке ошибка знака коэффициента и приводятся результаты бенчмарка на стандартном тестовом стенде.
Исторические данные – вовсе не "мусор", а основа любого надежного рыночного анализа. В этой статье мы шаг за шагом пройдем путь от сбора истории до ее использования для обучения прогностической модели, а затем – до развертывания этой модели для прогнозирования цен в реальном времени. Давайте разберемся, как это сделать.