Este artigo fornece uma visão detalhada sobre como construir uma classe em MQL5 para gerenciamento eficiente de arquivos CSV. Ele explica como os métodos de abertura, escrita, leitura e conversão de dados são implementados e como eles podem ser utilizados para armazenar e carregar dados. Além disso, o artigo também discute as limitações e considerações importantes ao usar essa classe. É uma leitura valiosa para aqueles interessados em aprender a trabalhar com arquivos CSV em MQL5.
O próximo algoritmo que abordaremos será a otimização de busca de cuco usando voos Levy. Este é um dos algoritmos de otimização mais recentes e um novo líder na tabela de classificação.
Vamos falar sobre um dos algoritmos de otimização mais recentes e modernos: o "Packs of grey wolves" (manada de lobos-cinzentos). Devido ao seu comportamento distinto em funções de teste, este algoritmo se torna um dos mais interessantes em comparação com outros considerados anteriormente. Ele é um dos principais candidatos para treinamento de redes neurais e para otimizar funções suaves com muitas variáveis.
Hoje estudaremos o algoritmo de colônia artificial de abelhas. Complementaremos nosso conhecimento com novos princípios para estudar espaços funcionais. E neste artigo falarei sobre minha interpretação da versão clássica do algoritmo.
Em um dos artigos desta série, já nos iniciamos no método aprendizado Q, que calcula a média da recompensa para cada ação. Em 2017, foram apresentados 2 trabalhos simultâneos, que tiveram sucesso quanto ao estudo da função de distribuição de recompensas. Vamos considerar a possibilidade de usar essa tecnologia para resolver nossos problemas.
O trader moderno está quase sempre à procura de novas ideias. Para isso, tenta novas estratégias, modifica e descarta aquelas que não funcionam. Nesta série de artigos, tentarei provar que o assistente MQL5 é a verdadeira espinha dorsal de um trader moderno.
Este é um algoritmo preguiçoso que não aprende com o conjunto de dados de treinamento, ele armazena o conjunto de dados e age imediatamente quando ele recebe uma nova amostra. Por mais simples que ele seja, ele é usado em uma variedade de aplicações do mundo real
A mineração de dados é crucial para um cientista de dados e um trader porque, muitas vezes, os dados não são tão diretos quanto pensamos, o olho humano não consegue entender o padrão subjacente menor e as relações no conjunto de dados, talvez o algoritmo K-means pode nos ajudar com isso. Vamos descobrir...
Ao contrário da regressão linear, a regressão polinomial é um modelo flexível destinado a performar melhor em tarefas que o modelo de regressão linear não poderia lidar. Vamos descobrir como fazer modelos polinomiais em MQL5 e tirar algo positivo disso.
O trader de hoje é um filomata que está quase sempre procurando novas ideias, experimentando-as, escolhendo modificá-las ou descartá-las; um processo exploratório que deve custar uma quantidade razoável de diligência. Esta série de artigos proporá que o assistente MQL5 deve ser um esteio para os traders.
No último artigo, iniciamos a análise dos métodos de otimização sem gradiente, e nos familiarizamos com o algoritmo genético. Hoje, continuaremos a discutir o mesmo assunto e também examinaremos outra classe de algoritmos evolutivos.
Desta vez, vamos dar uma olhada no algoritmo de otimização de colônia de formigas ("Ant Colony optimization algorithm", em inglês). O algoritmo é muito interessante e ambíguo. Trata-se de uma tentativa de criar um novo tipo de ACO.
Neste artigo vamos analisar o popular algoritmo de otimização por enxame de partículas (PSO). Anteriormente, discutimos características importantes de algoritmos de otimização, como convergência, velocidade de convergência, estabilidade, escalabilidade e desenvolvemos uma bancada de testes. Também analisamos um algoritmo simples baseado em geradores de números aleatórios (GNA).
Hoje quero apresentar-lhes um método de aprendizado um pouco diferente. Pode-se dizer que é emprestado da teoria da evolução de Darwin. É provavelmente menos controlável do que os métodos discutidos anteriormente. Mas, mesmo assim, permite também treinar modelos indiferenciados.
Nos artigos anteriores desta série, conhecemos 2 algoritmos de aprendizado por reforço. Cada um deles tem suas próprias vantagens e desvantagens. Como costuma acontecer quando nos deparamos com esses casos, surge a ideia de combinar os dois métodos em um algoritmo que incorpore o melhor dos dois. E assim compensar as deficiências de cada um deles. Falaremos sobre tal combinação de métodos neste artigo.
Continuamos a estudar métodos de aprendizado por reforço. No artigo anterior, nos iniciamos no método de aprendizado Q profundo. Com ele, treinamos um modelo para prever a recompensa imediata dependendo da ação tomada por nós em uma determinada situação. E, em seguida, realizamos uma ação de acordo com nossa política e a recompensa esperada. Mas nem sempre é possível aproximar a função Q ou nem sempre sua aproximação dá o resultado desejado. Nesses casos, os métodos de aproximação são usados não para funções de utilidade, mas, sim, para uma política (estratégia) direta de ações. E é precisamente a esses métodos que o gradiente de política pertence.
Há detalhes a serem abordadas na rede neural feed-forward antes de finalizarmos este assunto, a arquitetura é uma delas. Vamos ver como nós podemos construir e desenvolver uma rede neural flexível para as nossas entradas, o número de camadas ocultas e os nós para cada rede.
Continuamos nosso estudo sobre aprendizado por reforço. E, neste artigo, vamos nos familiarizar com o método de aprendizado Q profundo. Com esse método, a equipe do DeepMind criou um modelo que pode superar um humano ao jogar jogos do Atari. Acho que será útil avaliar as possibilidades de tal tecnologia para resolver problemas de negociação.
Continuamos a estudar métodos de aprendizado de máquina. Com este artigo, começamos outro grande tópico chamado aprendizado por reforço. Essa abordagem permite que os modelos estabeleçam certas estratégias para resolver as tarefas. E esperamos que essa propriedade inerente ao aprendizado de reforço abra novos horizontes para a construção de estratégias de negociação.
Nos dois últimos artigos, criamos uma ferramenta que permite criar e editar modelos de redes neurais. E agora é hora de avaliar o uso potencial da transferência de aprendizado (transfer learning, em inglês) usando exemplos práticos.
No último artigo, elaboramos uma ferramenta para criar e editar a arquitetura de redes neurais. E hoje quero convidá-lo a continuar trabalhando nela, para torná-la mais amigável. De certa forma, ao fazer isso, estamos nos afastando um pouco do nosso tópico. Mas convenhamos que a organização do espaço de trabalho desempenha um papel importante na obtenção do resultado.
Nesta série de artigos, já mencionamos a transferência de aprendizado mais de uma vez. Mas até agora o assunto não foi além das menções. Sugiro preencher essa lacuna e dar uma olhada mais de perto na transferência de aprendizado.
Continuamos a estudar algoritmos de aprendizado não supervisionado. E agora proponho discutir as particularidades por trás do uso de autocodificadores para treinar modelos recorrentes.
As redes neurais são tudo para nós. E vamos verificar na prática se é assim, indagando se MetaTrader 5 é uma ferramenta autossuficiente para implementar redes neurais na negociação. A explicação vai ser simples.
Muitas pessoas as amam, mas apenas alguns entendem todas as operações por trás das Redes Neurais. Neste artigo, eu tentarei explicar tudo o que acontece por trás dos bastidores de um perceptron multicamadas feed-forward de maneira simples.
O gradiente descendente desempenha um papel significativo no treinamento das redes neurais e muitos algoritmos de aprendizado de máquina. Ele é um algoritmo rápido e inteligente, apesar do seu trabalho impressionante, ele ainda é mal interpretado por muitos cientistas de dados, vamos ver do que ele se trata.
No último artigo, analisamos o algoritmo do autocodificador. Como qualquer outro algoritmo, tem suas vantagens e desvantagens. Na implementação original, o autocodificador executa a tarefa de separar os objetos da amostra de treinamento o máximo possível. E falaremos sobre como lidar com algumas de suas deficiências neste artigo.
Continuamos a estudar algoritmos de aprendizado não supervisionado. Talvez você como o leitor possa ter dúvidas sobre se as publicações recentes se encaixam no tópico de redes neurais. Neste novo artigo, voltamos ao uso de redes neurais.
Continuamos o tópico de busca de regras de associação. No artigo anterior, consideramos os aspectos teóricos desse tipo de problema. No artigo de hoje, ensinarei a implementação do método FP-Growth usando MQL5. Também vamos testá-la com dados reais.
As árvores de decisão imitam a maneira como os humanos pensam para classificar os dados. Vamos ver como construir árvores e usá-las para classificar e prever alguns dados. O principal objetivo do algoritmo de árvores de decisão é separar os dados impuros em puros ou próximos a nós.
Como continuação desta série, gostaria de apresentar a vocês outro tipo de tarefa dos métodos de aprendizado não supervisionado, em particular a busca de regras de associação. Este tipo de tarefa foi usado pela primeira vez no varejo para analisar cestas de compras. Neste artigo falaremos sobre as possibilidades de utilização de tais algoritmos no trading.
Neste artigo, eu tentarei usar nosso modelo logístico para prever o crash do mercado de ações com base nos fundamentos da economia dos EUA, nos concentraremos nas ações do NETFLIX e da APPLE, usando os crashes anteriores do mercado de 2019 e 2020, vamos ver como nosso modelo se comportará nas atuais desgraças e tristezas.
As redes neurais são tudo para nós. Vamos ver se isso é verdade na prática. Para tal, vamos fazer experiências e adotar abordagens não-convencionais. Vamos escrever também um sistema de negociação lucrativo. A explicação vai ser simples.
Metamodelos em aprendizado de máquina: Criação automática de sistemas de negociação com quase nenhum envolvimento humano, o próprio modelo decide como operar e quando operar.
Continuamos a estudar modelos de inteligência artificial, em particular, algoritmos de aprendizado não supervisionados. Já nos encontramos com um dos algoritmos de agrupamento. E neste artigo quero compartilhar com vocês outra maneira de resolver os problemas de redução de dimensionalidade.
Esta é uma seleção de materiais que será útil para que os operadores possam melhorar seus conhecimentos sobre negociação algorítmica. Os algoritmos simples são coisa do passado, agora é difícil alcançar o sucesso sem o uso de aprendizado de máquina e redes neurais.
No artigo anterior, construímos uma classe para agrupamento de dados. Hoje eu gostaria de compartilhar com vocês as formas mediante as quais os resultados podem ser usados para resolver problemas práticos de negociação.
Continuamos a estudar o método de agrupamento. Neste artigo, criaremos uma nova classe CKmeans para implementar um dos métodos de agrupamento k-médias mais comuns. Com base nos resultados dos testes, podemos concluir que o modelo é capaz de identificar cerca de 500 padrões.
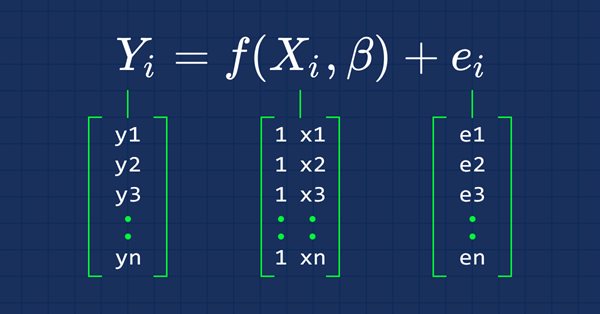
Desta vez nossos modelos estão sendo feitos por matrizes, o que permite flexibilidade ao mesmo tempo que nos permite fazer modelos poderosos que podem manipular não apenas cinco variáveis independentes, mas também muitas variáveis, desde que permaneçamos dentro dos limites de cálculos de um computador, este artigo será uma leitura interessante, isso é certo.
Devo confessar que já se passou mais de um ano desde que o último artigo foi publicado. Em um período tão longo como esse, é possível reconsiderar muitas coisas, desenvolver novas abordagens. E neste novo artigo, gostaria de me afastar um pouco do método de aprendizado supervisionado usado anteriormente, e sugerir um pouco de mergulho nos algoritmos de aprendizado não supervisionado. E, em particular, desejaria analisar um dos algoritmos de agrupamento, o k-médias (k-means).